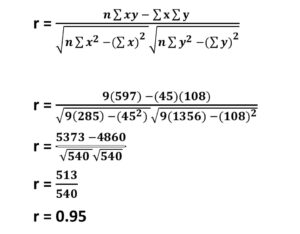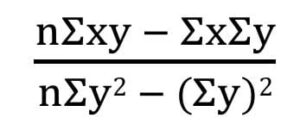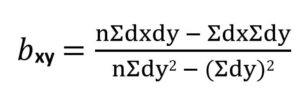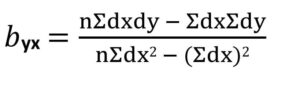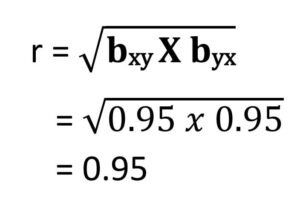Category RESEARCH METHODOLOGY

14. Measurement of Dispersion (प्रसरण / अपकिरण / विचलन / प्रकीर्णन / फैलाव का मापन)

Measurement of Dispersion

(प्रसरण का मापन)

Measurement of Dispersion

परिचय

     सांख्यिकी में केवल केन्द्रीय प्रवृत्ति के माप (Mean, Median, Mode) से किसी आँकड़ा-समूह की पूर्ण जानकारी नहीं मिलती। दो अलग-अलग आँकड़ा-समूहों का औसत समान हो सकता है, परंतु उनके मानों का फैलाव (विचलन) अलग-अलग हो सकता है। आँकड़ों के इसी फैलाव या बिखराव को प्रसरण (Dispersion) कहा जाता है। अतः प्रसरण का मापन यह बताता है कि आँकड़े अपने केन्द्रीय मान (Mean, Median, Mode) से कितनी दूरी तक फैले हुए हैं।

सरल शब्दों में, प्रसरण का मापन आँकड़ों की अस्थिरता, विविधता तथा समानता/असमानता को मापने का साधन है।

✍️ Dispersion measures the extent to which the items vary from some central value.

✍️ Average deviation is known as dispersion.

✍️ Central value- Mean, Median, Mode

✍️ Dispersion is also known as scatter, spread or variation.

Example 

(i) 2, 4, 9

AM = Σx/n

     = 2+4+9/3

       = 15/3

       = 3

(ii)

Series A Series B Series C
100 98 1
100 99 2
100 100 3
100 101 4
100 102 490
= 500/5 = 100 500/5 = 100 500/5 = 100

       यह तालिका दर्शाती है कि तीनों श्रेणियों (Series A, B और C) का औसत (̄ = 100) समान है, लेकिन मानों का वितरण अलग-अलग है। Series A में कोई प्रसरण नहीं, Series B में कम प्रसरण, जबकि Series C में अत्यधिक प्रसरण है।

प्रसरण की परिभाषा

        कई विद्वानों ने अपकिरण को परिभाषित किया है जिनमें निम्न प्रमुख हैं :-

(1) बुक्स एवं डिक (B. C. Brooks and W. F. L. Dick) के अनुसार, “अपकिरण अथवा प्रसार, एक केन्द्रीय मूल्य के इर्द-गिर्द चर मूल्यों (variables) के विचरण अथवा बिखराव की सीमा है।”

(2) प्रो. किंग (W. I. King) के शब्दों में, “अपकिरण शब्द का प्रयोग यह स्पष्ट करने के लिए किया जाता है कि एक दिये गये समूह के पद-मूल्यों में भिन्नता है। दूसरे शब्दों में, उसके मूल्यों में एकरूपता का अभाव है। “

(3) प्रो. कॉनर (L. R. Connor) के अनुसार, “अपकिरण उस सीमा, जिस तक व्यक्तिगत पद विलित है, की एक माप है।”

क्रॉक्सटन और काउडेन के अनुसार-

      “प्रसरण वह माप है जो यह दर्शाता है कि किसी श्रृंखला के व्यक्तिगत मान औसत के चारों ओर किस सीमा तक बिखरे हुए हैं।

प्रसरण के मापन की आवश्यकता (महत्त्व)

    प्रसरण के मापन की आवश्यकता निम्न कारणों से होती है-

✍️ आँकड़ों की स्थिरता या अस्थिरता का ज्ञान

✍️ दो या अधिक श्रृंखलाओं की तुलना

✍️ औसत की विश्वसनीयता जाँचने हेतु

✍️ जोखिम (Risk) और अनिश्चितता के विश्लेषण में

✍️ नीति निर्माण, योजना तथा अनुसंधान में सहायता

✍️ आर्थिक, भौगोलिक एवं सामाजिक अध्ययनों में उपयोग

प्रसरण के मापन के प्रकार

   प्रसरण के मापन को मुख्यतः दो भागों में बाँटा जाता है-

1. निरपेक्ष माप (Absolute Measures)

2. सापेक्ष माप (Relative Measures)

(1) निरपेक्ष माप (Absolute Measure):-

     जब किसी श्रेणी के बिखराव की माप निरपेक्ष रूप में उस श्रेणी की इकाई में ही व्यक्त की जाती है तो वह अपकिरण की निरपेक्ष माप कहलाती है, जैसे कीमत रुपयो में, लम्बाई मीटर में, वजन किलोग्राम में व्यक्त किया जाता है। यदि यह कहा जाए कि श्रमिको के एक समूह की औसत मजदूरी ₹200 है तथा अपकिरण ₹ 15 है तो यह मद अपकिरण का निरपेक्ष माप कहलाएगा।

    अपकिरण के ऐसे मापों की तुलना तभी सम्भव होती है जब दो श्रेणियाँ एक जैसी हो तथा उन्हें एक जैसी इकाइयां, जैसे-किलोग्राम, रुपये आदि द्वारा प्रकट किया जाए। यदि वितरण दो अलग समंकों से सम्बन्धित है तथा इनकी इकाइयाँ भिन्न है है तो ये माप तुलना में सहायक नहीं होते।

(2) सापेक्ष माप (Relative Measure):-

      जैसा कि हमने अध्ययन किया कि अपकिरण के निरपेक्ष माप में यह दोष है कि इसमें विभिन्न श्रेणियों की इकाइयों अलग-अलग होने पर उनमें परस्पर तुलना सम्भव नहीं होती है। अतः इनके मापों को तुलना योग्य बनाने के लिए इनको सापेक्ष रूप में बदला जाता है। अपकिरण के निरपेक्ष माप को श्रेणी के माध्य भाग देने पर जो अनुपात आता है, उसे अकिरण की सापेक्ष माप कहते हैं।

      उदाहरण के लिए, यदि कहा जाए कि भारत में 27 प्रतिशत व्यक्ति निर्धनता रेखा से नीचे है तो यह सापेक्ष माप होगी। सापेक्ष माप को ज्ञात करने के लिए मध्य मूल्य को औसत से भाग कर दिया जाता है या उसका प्रतिशन ज्ञात किया जाता है। स्पष्ट है कि सापेक्ष माप समंक श्रेणी की इकाई में व्यक्त न होकर एक अनुपात या प्रतिशत के रूप में व्यक्त होती है। इसे अपकिरण गुणांक (Co-efficient of Dispersion) भी कहते है।

अपकिरण मापने की विधियाँ (Method of  Measuring Dispersion)

        अपकिरण मापने की विधियाँ इस प्रकार है-

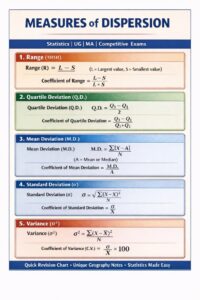
Measures of Dispersion
Absolute Measure (Same unit) Relative Measure (Unit free)
1. Rane 1. Coefficient of Range
2. Quartile Deviation 2. Coefficient of Quartile Deviation
3. Mean Deviation 3. Coefficient of Mean Deviation
4. Standard Deviation 4. Coefficient of Standard Deviation
5. Variance 5. Coefficient of Variance

निष्कर्ष:

     प्रसरण का मापन सांख्यिकी का एक अत्यंत महत्त्वपूर्ण अंग है। केवल औसत आँकड़ों की पूरी तस्वीर प्रस्तुत नहीं कर सकता, जब तक कि उसके साथ प्रसरण का अध्ययन न किया जाए।

    परास, चतुर्थक विचलन, औसत विचलन, परिवर्तन तथा मानक विचलन ये सभी प्रसरण के विभिन्न स्तरों को समझने में सहायक हैं। विशेष रूप से मानक विचलन और परिवर्तन गुणांक आधुनिक सांख्यिकीय विश्लेषण में सर्वाधिक उपयोगी माने जाते हैं।

    अतः किसी भी आँकड़ा-विश्लेषण को पूर्ण और विश्वसनीय बनाने के लिए प्रसरण के मापन का अध्ययन अनिवार्य है।


नोट: सिर्फ सांख्यिकीय माध्य का ज्ञान रखने वाले एक व्यक्ति ने सपरिवार नदी पार करने से पहले नदी की औसत गहराई और अपने परिवार की औसत ऊँचाई ज्ञात की।

    नदी की औसत गहराई 4 फीट तथा उसके परिका की औसत ऊँचाई 5 फीट थी। इस विश्वास के साथ सभी लोग नदी पार करने लगे, परन्तु एक स्थान पर नहीं की गहराई 10 फीट थी जहाँ वह परिवार डूब गया।

   यदि उस व्यक्ति ने नदी की अधिकतम गहराई और आने परिवार के सदस्यों की न्यूनतम ऊँचाई को गणना कर ली होती तो शायद यह कहावत सुनने को नहीं मिलती कि-

लेखा जोखा ज्यों का त्यों,

सारा कुनबा डूबा क्यों।

    वह व्यक्ति सपरिवार डूब गया क्योंकि उसे अपकिरण की माप की जानकारी नहीं थी। अपकिरण की माप से हमे इस बात की जानकारी मिलती है कि आंकड़े औसत से कितनी दूरी पर अवस्थित है।

     उपर्युक्त लघु-कथा यह स्पष्ट करती है कि विभिन्न पद-मूल्यों का माध्य में विचलन महत्वपूर्ण होता है। किसी देश में औसत आय अथवा सम्पति काफी अधिक हो सकती है, साथ ही वहाँ उसके वितरण में पर्याप्त असमानता के कारण अधिकांश जनसंख्या निर्धनता की सीमा के नीचे हो सकती है। इस प्रकार के विचलनों को मापना तथा उन्हें एक संख्या में व्यक्त करना आवश्यक होता है।

16. Scatter Diagram (स्कैटर आरेख)

Scatter Diagram

(स्कैटर आरेख)


Scatter Diagram

    सांख्यिकी (Statistics) में सहसंबंध (Correlation) का अर्थ दो चरों (Variables) के बीच संबंध की दिशा और मात्रा को समझना होता है। यह बताता है कि एक चर में परिवर्तन होने पर दूसरा चर किस प्रकार प्रभावित होता है।

    सहसंबंध के अध्ययन में स्कैटर आरेख (Scatter Diagram) एक अत्यंत सरल, दृश्यात्मक और प्रभावी विधि है, जिसके माध्यम से दो चरों के बीच संबंध को आसानी से समझा जा सकता है।

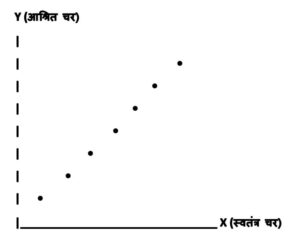
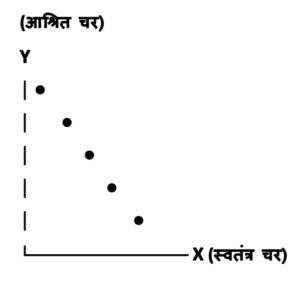
    स्कैटर आरेख को बिंदु आरेख भी कहा जाता है। इसमें दो चरों के मानों को ग्राफ पर बिंदुओं के रूप में दर्शाया जाता है। सामान्यतः स्वतंत्र चर (Independent Variable) को X-अक्ष पर और आश्रित चर (Dependent Variable) को Y-अक्ष पर अंकित किया जाता है।

    प्रत्येक युग्म (X, Y) को ग्राफ पर एक बिंदु (•) के रूप में प्रदर्शित किया जाता है। इन बिंदुओं के फैलाव और उनके झुकाव (Trend) से सहसंबंध की प्रकृति का अनुमान लगाया जाता है।

स्कैटर डायग्राम की परिभाषा

     स्कैटर डायग्राम वह आरेख है, जिसमें दो चरों से संबंधित आँकड़ों को ग्राफ पेपर पर बिंदुओं (Dots) के रूप में दर्शाया जाता है। एक चर को X-अक्ष (क्षैतिज अक्ष) पर तथा दूसरे चर को Y-अक्ष (ऊर्ध्वाधर अक्ष) पर रखा जाता है। दोनों चरों के मानों के युग्म (X, Y) को ग्राफ पर बिंदु के रूप में अंकित किया जाता है। इन बिंदुओं के फैलाव (Scatter) से यह ज्ञात होता है कि चरों के बीच किस प्रकार का सहसंबंध है।

स्कैटर डायग्राम की विशेषताएँ

    स्कैटर डायग्राम की कुछ प्रमुख विशेषताएँ निम्नलिखित हैं-

✍️ यह सहसंबंध को समझने की सबसे सरल और प्रारंभिक विधि है।

✍️ इसमें जटिल गणनाओं की आवश्यकता नहीं होती।

✍️ यह केवल सहसंबंध की दिशा और प्रकृति बताता है, उसकी सटीक मात्रा नहीं।

✍️ यह शोधकर्ताओं और विद्यार्थियों के लिए अत्यंत उपयोगी है।

✍️ यह सकारात्मक, नकारात्मक और शून्य सहसंबंध को स्पष्ट रूप से दर्शाता है।

स्कैटर डायग्राम बनाने की विधि

    स्कैटर डायग्राम बनाने की प्रक्रिया को निम्न चरणों में समझा जा सकता है-

(i) आँकड़ों का चयन:-

    सबसे पहले दो चरों से संबंधित आँकड़ों का चयन किया जाता है, जैसे- वर्षा और फसल उत्पादन, तापमान और आर्द्रता, जनसंख्या और संसाधन आदि।

(ii) अक्षों का निर्धारण:-

   एक चर को X-अक्ष पर और दूसरे चर को Y-अक्ष पर रखा जाता है। सामान्यतः स्वतंत्र चर (Independent Variable) को X-अक्ष पर और आश्रित चर (Dependent Variable) को Y-अक्ष पर रखा जाता है।

(iii) पैमाने का चयन:-

    दोनों अक्षों पर उपयुक्त पैमाना (Scale) निर्धारित किया जाता है, जिससे सभी मान ग्राफ पर सही ढंग से दर्शाया जा सकें।

(iv) बिंदुओं का अंकन:-

   प्रत्येक युग्म मान (X, Y) को ग्राफ पर केवल एक बिंदु के रूप में न कि रेखा रूप में अंकित किया जाता है।

(v) बिंदुओं का अवलोकन:-

   अंकित बिंदुओं के फैलाव को देखकर सहसंबंध की दिशा और प्रकार का अनुमान लगाया जाता है।

स्कैटर डायग्राम के प्रकार

     स्कैटर आरेख / डायग्राम में बिंदुओं वितरण की स्थिति के आधार पर सहसंबंध को निम्न प्रकारों में समझा जा सकता है-

(i) सकारात्मक सहसंबंध (Positive Correlation)

    जब एक चर के बढ़ने पर दूसरा चर भी बढ़ता है, या एक चर के घटने पर दूसरा भी घटता है, तो उसे सकारात्मक सहसंबंध कहते हैं। स्कैटर डायग्राम में ऐसे बिंदु बाएँ से दाएँ ऊपर की ओर जाते हुए दिखाई देते हैं।

उदाहरण-

⇒ आय और उपभोग

⇒ वर्षा और कृषि उत्पादन

(ii) नकारात्मक सहसंबंध (Negative Correlation)

    जब एक चर के बढ़ने पर दूसरा चर घटता है, तो उसे नकारात्मक सहसंबंध कहते हैं। स्कैटर डायग्राम में बिंदु बाएँ से दाएँ नीचे की ओर ढलान बनाते हैं।

उदाहरण-

⇒ मूल्य और माँग

⇒ ऊँचाई और तापमान

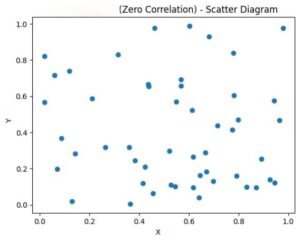
(iii) शून्य सहसंबंध (Zero Correlation)

    जब दो चरों के बीच कोई निश्चित संबंध नहीं होता, तो उसे शून्य सहसंबंध कहते हैं। स्कैटर डायग्राम में बिंदु अनियमित रूप से बिखरे होते हैं।
उदाहरण-

⇒ जूते का साइज और बुद्धि

⇒ जन्म-तिथि और परीक्षा-अंक

स्कैटर डायग्राम के लाभ

✍️ यह सहसंबंध को सरल और दृश्य रूप में प्रस्तुत करता है।

✍️ यह प्रारंभिक विश्लेषण के लिए अत्यंत उपयोगी है।

✍️ इसे बनाना और समझना आसान है।

✍️ यह आँकड़ों में किसी भी असामान्यता (Outlier) को स्पष्ट दिखा देता है।

✍️ यह आगे की सांख्यिकीय विधियों (जैसे Karl Pearson सहसंबंध) के लिए आधार प्रदान करता है।

सीमाएँ

    स्कैटर डायग्राम की निम्नलिखित सीमाएँ है-

✍️ यह सहसंबंध की सटीक मात्रा नहीं बताता।

✍️ बड़े आँकड़ों में बिंदु आपस में मिल जाते हैं, जिससे स्पष्टता कम हो जाती है।

✍️ यह केवल दो चरों के बीच संबंध दर्शा सकता है।

✍️ व्यक्तिगत व्याख्या (Subjective Interpretation) पर अधिक निर्भर करता है।

भूगोल एवं अन्य विषयों में उपयोग

   स्कैटर डायग्राम का प्रयोग भूगोल, अर्थशास्त्र, समाजशास्त्र, जनसंख्या अध्ययन, पर्यावरण अध्ययन आदि में व्यापक रूप से किया जाता है।

भूगोल में उपयोग जैसे-

  वर्षा और नदी प्रवाह, जनसंख्या घनत्व और संसाधन, तापमान और वनस्पति जैसे संबंधों को समझने के लिए स्कैटर डायग्राम अत्यंत उपयोगी है।

निष्कर्ष:

   अतः कहा जा सकता है कि सहसंबंध के अध्ययन में स्कैटर डायग्राम एक सरल, प्रभावी और उपयोगी ग्राफिकल विधि है। यह दो चरों के बीच संबंध की दिशा और प्रकृति को स्पष्ट रूप से दर्शाता है।

    यद्यपि इसकी कुछ सीमाएँ हैं, फिर भी प्रारंभिक विश्लेषण और शोध के लिए इसका महत्व अत्यधिक है। सांख्यिकी और भूगोल के विद्यार्थियों के लिए स्कैटर डायग्राम सहसंबंध को समझने का एक मजबूत आधार प्रदान करता है।

14. Correlation analysis (सहसंबंध विश्लेषण)

Correlation analysis

(सहसंबंध विश्लेषण)


⇒ Correlation analysis deals with the association between two or more Variables.

⇒ The degree of relationship between the Variables Under consideration is measured through the correlation analysis.

⇒ The measure of correlation called the “Correlation coefficient or correlation index” Summarizes in Figure the direction & degree one of correlation.

Example1

x⇑ y⇑
10 15
12 20
15 22
18 25
20 37
25 43

👉  ऊपर दिए गए आँकड़ों में x और y के मानों को देखने पर स्पष्ट होता है कि जैसे-जैसे x का मान बढ़ता है, वैसे-वैसे y का मान भी बढ़ रहा है।

👉  अर्थात्, x में वृद्धि होने पर y में भी वृद्धि की प्रवृत्ति दिखाई देती है, जिससे दोनों चर आपस में सकारात्मक रूप से संबंधित हैं।

👉 यहाँ x और y के बीच धनात्मक (Positive) सहसंबंध है।

Example2

x⇑ y⇓
20 40
30 30
40 22
50 15
60 10
80 4

👉  दिए गए आँकड़ों में जैसे-जैसे x का मान बढ़ता है, वैसे-वैसे y का मान घटता जाता है

👉  अतः x और y के बीच नकारात्मक (ऋणात्मक) सहसंबंध पाया जाता है।

👉  चूँकि परिवर्तन नियमित और स्पष्ट है, इसलिए यह प्रबल नकारात्मक सहसंबंध (Strong Negative Correlation) को दर्शाता है।

Type of Correlation

1. Positive Correlation (Direct Correlation):-

   If both the Variable in Same direction. x⇑, y⇑ or x⇓, y⇓ e.g., Height & Weight, Rainfall & Yeild

2. Negative Correlation (Inverse Correlation):-

    If both the variables Varies in opposite direction. x⇑, y⇓ or x⇓, y⇑ e.g., Price & Demand

3. Zero Correlation (No Correlation):-

      When there is no relationship between variables. or When one variable changes, the other variable does not change in any consistent way. x⇑⇓, y or x, y⇑⇓ e.g., Shoe size & intelligence

Correlation Coefficient (r)

     The correlation coefficient is a statistical measure that shows the strength and direction of the relationship between two variables. Its value ranges from −1 to +1, where positive values indicate direct correlation, negative values indicate inverse correlation, and zero indicates no relationship.

r = +1 ⇒ Perfect Positive Correlation,

r = -1 ⇒ Perfect Negative Correlation,

r = 0 ⇒ No Relation,

r = 0.8, 0.9, 0.95 अर्थात जब r का Value 1 के करीब आता है तो उसे Strong +ve Correlation कहा जाता है।

r = -0.85, -0.9, -0.95 अर्थात जब r का Value लगभग -1 के करीब आता है तो उसे Strong Negative Correlation कहा जाता है।

Method of Finding Correlation Coefficient (r)

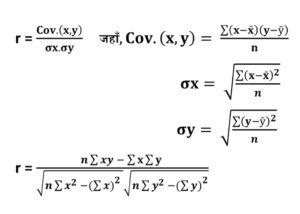
          The correlation coefficient (r) is found using several methods. The Karl Pearson’s method is the most common, where r is calculated by dividing the covariance of two variables by the product of their standard deviations.

     The Spearman’s rank correlation method is used when data are ranked or not normally distributed.

    Another method is the concurrent deviations method, suitable for time-series data showing direction of change.

             Scatter diagram method finds correlation coefficient (r) by plotting paired data points, observing pattern direction, and estimating strength visually.

   These methods help measure the degree and direction of relationship between variables, with values of r ranging from –1 to +1.

1. Karl Pearson’s method

2. Spearman’s rank correlation method

3. Concurrent deviations method

4. Scatter diagram method

1. Karl Pearson’s Product Moment Method

      Karl Pearson’s Product Moment Method measures the degree and direction of linear relationship between two quantitative variables. It uses covariance divided by the product of their standard deviations, producing a correlation coefficient (r) ranging from –1 to +1, indicating negative, positive, or no correlation.


Ex. (i) Find coefficient of correlation of the following data.

x y
9 15
8 16
7 14
6 13
5 11
4 12
3 10
2 8
1 9

Solution:

x y x2 y2 xy
9 15 81 225 135
8 16 64 256 128
7 14 49 196 98
6 13 36 169 78
5 11 25 121 55
4 12 16 144 48
3 10 9 100 30
2 8 4 64 16
1 9 1 81 9
Total sum = 45 108 285 1356 597

n = No. of pair of observers

n = 9

Σxy = 597

Σx = 45

Σy = 108

Σx2 = 285

Σy2 = 1356

Correlation analysis

17. Nearest Neighbor Analysis (निकटतम पड़ोसी विश्लेषण)

Nearest Neighbor Analysis

(निकटतम पड़ोसी विश्लेषण)


Nearest Neighbor Analysis

परिचय

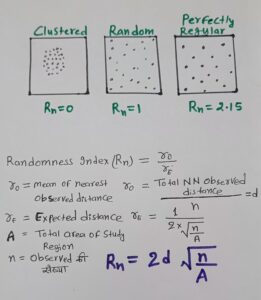
    निकटतम पड़ोसी विश्लेषण (Nearest Neighbor Analysis) एक प्रकार की स्थानिक सांख्यिकीय तकनीक है जिसका उपयोग भौगोलिक प्रतिरूप, वितरण और दूरी के अध्ययन के लिए किया जाता है।

    यह विश्लेषण बताता है कि किसी वस्तु (जैसे कि शहर, पौधे, जीव, अपराध स्थल आदि) का वितरण सांख्यिकीय रूप से समूहित (Clustered), यादृच्छिक (Random) या समान (Regular/Uniform) रूप से फैलाव वाला  है या नहीं।

    भौगोलिक सूचना प्रणाली (GIS) और स्थानिक आंकड़ों के अध्ययन में यह तकनीक अत्यंत महत्वपूर्ण है क्योंकि यह स्थानिक संरचना और प्रतिरूप का वैज्ञानिक मूल्यांकन करने में मदद करती है।

उद्देश्य

    निकटतम पड़ोसी विश्लेषण के मुख्य उद्देश्य निम्नलिखित हैं:

(i) किसी वस्तु का स्थानिक वितरण पैटर्न पहचानना।

(ii) यह जांचना कि क्या वितरण यादृच्छिक, समूहित या समान रूप से फैला है।

(iii) शहरी और ग्रामीण योजना में केंद्रों की उचित व्यवस्था सुनिश्चित करना।

(iv) आर्थिक और पर्यावरणीय अध्ययन में प्राकृतिक संसाधनों के वितरण का विश्लेषण।

(v) आपदा प्रबंधन और आपूर्ति श्रृंखला योजना में उपयोग।

सिद्धांत

     निकटतम पड़ोसी विश्लेषण निम्नलिखित आधार पर कार्य करता है:

⇒ प्रत्येक बिंदु के लिए सबसे नजदीकी पड़ोसी की दूरी मापी जाती है।

⇒ इन दूरी का औसत लिया जाता है।

⇒ इसे यादृच्छिक वितरण से तुलना की जाती है।

⇒ यदि बिंदु बहुत पास-पास हैं तो सामूहिक (Clustered)

⇒ यदि बिंदु असमान हैं तो यादृच्छिक (Random)

⇒ यदि बिंदु एक समान रूप से फैले हैं तो समान (Regular/Uniform)

मुख्य सूत्र:

Rn (Randomness Index) अनुपात निकालना:

Nearest Neighbor Analysis

उपयोग

(i) शहरी योजना: विद्यालय, अस्पताल, बस स्टॉप आदि का स्थानिक वितरण समझने के लिए।

(ii) पर्यावरण अध्ययन: पौधों और जीवों का वितरण।

(iii) अपराध भूगोल: अपराध स्थलों का क्लस्टरिंग पैटर्न पहचानना।

(iv) संसाधन प्रबंधन: जल स्रोत, खनिज आदि का स्थानिक विश्लेषण।

(v) सामाजिक अध्ययन: बाजार, बैंक या अन्य सेवाओं का वितरण।

निष्कर्ष:

     निकटतम पड़ोसी विश्लेषण एक सरल परंतु शक्तिशाली तकनीक है, जो स्थानिक वितरण पैटर्न को समझने और मूल्यांकन करने में मदद करती है। यह शहरी, पर्यावरणीय, आर्थिक और सामाजिक अध्ययन में अत्यंत उपयोगी है। सही डेटा और सॉफ्टवेयर टूल के साथ, यह यादृच्छिक, समूहित और समान वितरण को स्पष्ट रूप से पहचान सकता है और नीति निर्माण और योजना में महत्वपूर्ण योगदान देता है।

16. Regression Analysis (प्रतीगमन या प्रत्यागमन विश्लेषण)

Regression Analysis

(प्रतीगमन या प्रत्यागमन विश्लेषण)


Regression Analysis

परिचय

      ‘प्रतीपगमन’ (Regression) शब्द का अर्थ ‘पीछे लौटना’ अथवा ‘वापस आना’ (to regress or return back) है। इस शब्द का सर्वप्रथम प्रयोग 1877 में सर फ्रांसिस गाल्टन (Sir Francis Galton) ने अपने शोध लेख ‘पैतृक ऊँचाई में मध्यमता की ओर प्रतीपगमन’ (Regression towards mediocrity in hereditary stature) में किया था।

     प्रत्यागमन विश्लेषण (Regression Analysis) सांख्यिकी का एक अत्यंत महत्वपूर्ण विश्लेषणात्मक उपकरण है, जिसका उपयोग दो या दो से अधिक चर (Variables) के बीच संबंधों का अध्ययन करने के लिए किया जाता है। यह न केवल चर के बीच संबंधों की दिशा एवं ताकत को मापता है, बल्कि इस आधार पर भविष्य के मूल्यों का पूर्वानुमान (Prediction) भी करता है। इसीलिए इसे पूर्वानुमान के लिए सबसे प्रभावी सांख्यिकीय विधियों में से एक माना जाता है।

      प्रत्यागमन विश्लेषण मुख्य रूप से निर्भर चर (Dependent Variable) और स्वतंत्र चर (Independent Variable) के बीच संबंधों पर आधारित होता है। उदाहरण के लिए, यदि हम जानना चाहें कि किसी छात्र के परीक्षा-अंक उसकी पढ़ाई के घंटों पर कैसे निर्भर करते हैं, तो हम Regression Analysis का उपयोग करेंगे।

प्रत्यागमन विश्लेषण की परिभाषा     

      “Regression उस सांख्यिकीय तकनीक को कहते हैं जिसके द्वारा दो चर के बीच मात्रात्मक संबंध स्थापित किया जाता है और उसके आधार पर संबंधित चर के मूल्यों का अनुमान लगाया जाता है।”

सक्षेप में-

    Regression वह पद्धति है जिसमें हम एक चर के माध्यम से दूसरे चर के मूल्यों का अनुमान लगाते हैं।

Regression Analysis की आवश्यकता और उपयोगिता

(i) पूर्वानुमान (Prediction):-

          Regression Analysis की आवश्यकता और उपयोगिता पूर्वानुमान में इसलिए है कि यह चर (variables) के बीच संबंध स्थापित कर भविष्य के मानों का अनुमान लगाने, रुझान पहचानने और निर्णय-निर्धारण में सहायता करता है।

    बिक्री, उत्पादन, मांग, तापमान, GDP, जनसंख्या आदि का भविष्य अनुमान लगाने में उपयोगी।

(ii) निर्णय-निर्माण (Decision Making):-

    Regression Analysis की आवश्यकता निर्णय-निर्माण में इसलिए होती है क्योंकि यह भविष्य के रुझानों का अनुमान, चर-परिवर्तनशीलताओं का प्रभाव और नीतिगत या व्यावसायिक विकल्पों की सटीकता को बढ़ाता है।

(iv) चर-संबंधों का अध्ययन:-

  Regression Analysis की आवश्यकता चर-संबंधों को मात्रात्मक रूप से समझने, पूर्वानुमान बनाने, कारण-प्रभाव दिशा पहचानने और विभिन्न स्वतंत्र चरों का आश्रित चर पर प्रभाव मापने में होती है;

(v) प्रत्यक्ष एवं अप्रत्यक्ष प्रभावों की माप

   जैसे- आय का उपभोग पर प्रभाव, शिक्षा का आय पर प्रभाव।

(vi) वैज्ञानिक व सामाजिक अनुसंधान में उपयोग

    मनोविज्ञान, जनसांख्यिकी, भौतिकी, जीवविज्ञान, भूगोल आदि में व्यापक उपयोग।

Regression के प्रकार (Types of Regression Analysis)

1. Simple Regression (सरल प्रत्यागमन)

     जब एक स्वतंत्र चर और एक निर्भर चर के बीच संबंध स्थापित किया जाता है।

उदा.—उपभोग (Y) = f (आय X)

Regression Equation: Y = a+bX

2. Multiple Regression (बहु-प्रत्यागमन)

जब अनेक स्वतंत्र चर किसी एक निर्भर चर को प्रभावित करते हैं।

उदा.- आय (Y) = शिक्षा (X₁) + अनुभव (X₂) + कौशल (X₃)

Equation: Y=a+b1X1+b2X2+b3X3…….

3. Linear Regression (रेखीय प्रत्यागमन)

    जहाँ निर्भर चर और स्वतंत्र चर के बीच संबंध सीधी रेखा के रूप में हो।

Y = a+bX

Regression Line (प्रत्यागमन रेखा)

    Regression Analysis का मुख्य उद्देश्य एक ऐसी रेखा खोजना होता है जो स्वतंत्र चर और निर्भर चर के बीच न्यूनतम त्रुटि (Minimum Error) के साथ संबंध दर्शाए।

Regression Coefficient (प्रत्यागमन गुणांक)

     Regression coefficient (b) यह बताता है कि स्वतंत्र चर में एक इकाई परिवर्तन होने पर निर्भर चर में कितना परिवर्तन होगा।

उदाहरण:

यदि b = 0.8

तो X में 1 इकाई वृद्धि होने पर Y में 0.8 इकाई वृद्धि होगी।

Regression coefficient के गुण:

⇒ b का मान धनात्मक (+) या ऋणात्मक (–) दोनों हो सकता है।

⇒ b = 0 मतलब दोनों चरों में कोई संबंध नहीं।

⇒ यदि दोनों b (bxy और byx) धनात्मक हों = सीधा संबंध।

⇒ यदि दोनों b ऋणात्मक हों = व्युत्क्रम संबंध।

Regression Analysis का एक सरल उदाहरण

        मान लीजिए किसी छात्र ने पढ़ाई (X) के घंटे और परीक्षा-अंक (Y) का विवरण दिया:

X (घंटे) Y (अंक)
2 40
3 50
4 60
5 70

Regression Equation:

Y=a+bX

यदि गणना से प्राप्त हो:

a = 20, b = 10

तो समीकरण होगा:

Y = 20+10X

यदि X = 6 घंटे पढ़ाई →

Y = 20+10(6)=80

अर्थात छात्र अनुमानतः 80 अंक प्राप्त करेगा।

Correlation और Regression में अंतर

बिंदु Correlation Regression
उद्देश्य संबंध मापना पूर्वानुमान करना
संबंध दिशा केवल दिशा/मजबूती बताता है आश्रित व स्वतंत्र का संबंध बताता है
Variables कोई dependent नहीं Y dependent, X independent
मान सीमा -1 से +1 कोई भी मान
परिणाम r (सहसंबंध गुणांक) Y = a + bX (प्रतिगमन समीकरण)
उपयोग संबंध की मजबूती Prediction (पूर्वानुमान)
निष्कर्ष

     प्रत्यागमन विश्लेषण एक अत्यंत प्रभावी एवं वैज्ञानिक सांख्यिकीय तकनीक है जो विभिन्न क्षेत्रों में भविष्य के अनुमान लगाने, संबंधों को समझने और निर्णय लेने में महत्वपूर्ण भूमिका निभाती है। यह केवल दो चरों के बीच संबंधों का मात्रात्मक विश्लेषण ही नहीं करता, बल्कि इसके आधार पर व्यावहारिक समाधान भी प्रदान करता है।

   सटीक एवं विश्वसनीय आंकड़ों के साथ उपयोग करने पर Regression Analysis शोध, अर्थव्यवस्था, विज्ञान, समाजशास्त्र, नीति-निर्माण और व्यावसायिक क्षेत्रों में अत्यंत उपयोगी सिद्ध होता है।

नोट:  गाल्टन ने लगभग एक सहस्र पिताओं तथा पुत्रो की ऊँचाइयों का अन्वेषण करके यह ज्ञात किया कि “लम्बे पिताओं के पुत्र भी लम्बे होते है, तथा छोटे पिताओं के पुत्र भी छोटे होते हैं, परन्तु लम्बे पिताओं के पुत्री की औसत ऊँचाई उनके पिताओं की ऊँचाई की औसत से कम होती है तथा छोटे पिताओं के पुत्रों की औसत ऊँचाई उनके पिताओं की ऊँचाई की औसत से अधिक होती है।”

     गाल्टन ने मानव जाति में सामान्य ऊँचाई (normal height) की ओर लौटने की प्रवृत्ति को प्रतीपगमन को संज्ञा दी है।


उत्तर लिखने का दूसरा तरीका


Regression Analysis

Introduction:

     The mutual relationship between two Series is measured with the help of Correlation. Under correlation the direction and magnitude of the relationship between two variables is measured. But it is not possible to make the best estimate of the value of a dependent Variable on the basis of the given value of the Independent Variable by correlation analysis.

     Therefor, to make the best estimates and future estimation, the Study of regression analysis is very Important useful.

Meaning:

     Regression is the Study of the nature of relationship between that one may be able to Predict the Unknown value of one variable for a known value of another Variable.

     In regression, one variable is considered as an independent Variable and another Variable is taken as dependent Variable. with the help of regression, possible values of the dependent Variable are estimated on the basis of values of the independent variable.

     for example demand and price.

On the basis of this relationship between demand and price probable Value of demand can be estimated Corresponding to the different Values of place.

⇒ Regression Analysis is the technique for measuring or estimating the relationship among Variables.

⇒ Regression Analysis provides estimates of Values of the dependent Variable From the Values of the independent Variable.

⇒ The device used to accomplish this estimation procedure is the regression line.

⇒ The regression line describes the average relationship existing between x and y.

Exmple-

x y
4 100
7 92
15 90
18 82
20 79
25 74
28 68
. .
. .
35 ?    (here, x given, y=?)
. .
. .
?  (here, y given, x=?) 20

Difference Between Correlation and Regression

Correlation Analysis Regression Analysis
1. Correlation coefficient  is a measure of degree of covariability between x and y. 1. Objective of regression analysis is to Study the nature of relationship between Variables.
2. In Correlation analysis we can not say that one Variable is the cause & other the effect. 2. in regression analysis it is possible to study Cause & effect relationship.
3. In Correlation analysis both rxy & ryx are Symmetric (rxy=ryx) 3. In regression analysis bxy & byx are not Symmetric. (bxy≠byx)
4. There may be measure Correlation which has no practical relevance such as Increase in income & increase in weight. 4. There is nothing like non-Sense regression.
5. Correlation coeff. is independent of change of scale and origin.  5. Regression coefficientsare independent of change of origin but not of scale.

Similarity: Correlation coeff. (r) and regression coeff. (bxy & byx always have Same Sign.

UTILITY OF REGRESSION

(i) Nature of Relationship:-

    Regression analysis explains the nature of relationship between two variables.

(ii) Estimation of Relationship:-

     The mutual relationship between two or more variables can be measured easily by regression analysis.

(iii) Prediction:-

      By regression analysis, the value of a dependent variable can be predicted on the basis of the value of an independent variable. For example, if the price of a commodity rises, what will be the probable fall in demand, this can be predicted by regression.

(iv) Useful in Economic and Business research:-

    Regression analysis is very useful in business and economic research. With the help of regression, business and economic policies can be formulated.

TYPES OF REGRESSION ANALYSIS

1. Simple and Multiple Regression:-

      In simple regression analysis, we study only two variables at the time, in which one variable is dependent and another is independent. For example income and expenditure.

      on the contrary, we study more than two variables at a time in multiple, regression analysis in which one is dependent variable and others are independent variable. For example the study of rain and irrigation, the study of effect of rain and irrigation on yield of wheat.

2. Linear and Non-Linear Regression:-

    when one variable changes with other variable in some fixed ratio, this is called linear regression. such type of relationship is depicted on a graph by means of straight line.

    On the other hand when one variable varies with other variable in a changing ratio, then it is referred to as curvi-linear or Non-linear regression. This relationship, expressed on a graph paper takes the form of curve.

3. Partial and Total Regression:-

     When two or more variables are studied for functional relationship but at a time relationship between only two variables is studied and other variables held constant then it is known as partial regression. On the other hand, in total regression all variables are studied simultaneous for the relationship among them.

Simple Linear Regression

Regression lines:

     Regression lines are linear equations that show the relationship between two variables. These help in making predictions, understanding trends and determining the direction of changes in the data.

Regression lines
Regression line of y on x Regression line of x on y
1. y-ȳ = byx (x-x̄)

byx is regression coeff. of y on x

byx =

1. x-x̄ = bxy (y-ȳ)

bxy is regression coeff. of x on y

bxy =

Both lines intersect at point (x̄, ȳ),  x̄ = Mean of x, ȳ = Mean of y
2. x→ Independent variable

y→ Dependent variable

2. x→Dependent variable

y→ Independent variable

3. Used to calculate y for given x 3. Used to calculate y for given y
4. Regression equation of y on x, y = a+bx 4. Regression equation of x on y, x = a+by

Methods of Obtaining Regression Lines

(i) Scatter Diagram Method:-

      This is the simplest method of constructing regression lines, In this method, values of the related variables are plotted on a graph. A straight line is drawn passing through the plotted points. The straight line is drawn with free hand. This shape of regression line can be linear or non-linear also. This depends upon the location of plotted points. This method is very rarely used in practicle because in this method, the decision of the person who draws the regression lines very much affects the result.

(ii) Least Square Method:-

    Regression lines are also constructed by least Square method. Under this method, the two regression lines, is fitted through different points in such a way that the sum of squares of the deviations of the observed values from the fitted line shall be least. The line drawn by this method is called the Line of Best Fit. In other words, regression line of Y on X is so drawn such that vertically, the sum of squared deviation becomes minimum relating to the different points and the regression line on X on Y is so drawn such that horizontally, squared deviations of different points add up to minimum.

Regression Lines

and

Degree of Correlation

REGRESSION EQUATIONS

   Regression equations are the algebraic formulation of regression lines. Regression equations present Regression lines.

(i) Regression equation of x on y

     This equation is used to estimate the probable value of x on the basis of the given value of y.

⇒ x-x̄ = bxy (y-ȳ)

(ii) Regression Equation of y on x

     This equation is used to estimate the probable value of y on the basis of given value of x.

⇒ y-ȳ = byx (x-x̄)

REGRESSION COEFFICIENTS

    Regression Coefficient measures the average change in the value of one variable for a unit change in the value of another variable. r Infact, it represents the slope of a regression line.

(i) Regression Coefficient x on y

     This Coefficient shows that with the unit change in the value of y variable, what will be the average change in the value of x variable.

bxy = r . σx/σy

(ii) Regression coefficient of y on x

    This Coefficient shows that with a unit change in the value of x variable, what will be the average change in the value of y variable.

byx = r . σy/σx

Example (i) Find both regression lines (x on y and y on x) for the following data.

x y
6 9
2 11
10 5
4 8
8 7

Calculation:

x y x2 y2 xy
6 9 36 81 54
2 11 4 121 22
10 5 100 25 50
4 8 16 64 32
8 7 64 49 56
30 40 220 340 214

n = 5

x̄ = Σx/n = 30/5 = 6

ȳ = Σy/n = 40/5 = 8

byx =

= 5×214 – 30×40 / 5×220 – 30×30

= -0.65

bxy =

= 5×214 – 30×40 / 5×340 – 40×40

= -1.3

now,

x on y ⇒ x-x̄ = bxy (y-ȳ)

⇒ x-6 = -1.3(y-8)

⇒ x-6 = -1.3y + 1.3×8

⇒ x = -1.3y + 10.4 + 6

⇒ x = -1.3y + 16.4

y on x ⇒ y-ȳ = byx (x-x̄)

⇒ y-8 = -0.65 (x-6)

⇒ y-8 = -0.65x + 0.65×6

⇒ y = -0.65x + 3.9+8

⇒ y = -0.65x + 11.9

Example (ii) From the following data:

(a) Obtain two regression lines

(b) Calculate correlation coeff.

(c) Estimate the value of y for x = 6.2

x y
1 9
2 8
3 10
4 12
5 11
6 13
7 14
8 16
9 15

Calculation:

(a) Obtain two regression lines

Note: x on y ⇒ x-x̄ = bxy (y-ȳ)

y on x ⇒ y-ȳ = byx (x-x̄)

(i) For direct method 

We’ll need ⇒ x̄, ȳ, bxy, byx

r =

bxy =

byx =

Finally we’ll need ⇒ n, Σx, Σy, Σx2, Σy2, Σxy 

(ii) For Short-cut method :-

       समानान्तर माध्य की संख्या पूर्णांक में हो तो प्रत्यक्ष रीति द्वारा प्रतीपगमन गुणांक सरलता से प्राप्त किये जा सकते हैं, लेकिन यदि ये माध्य पूर्णांक में नहीं आये तब लघु रीति अपनाना अधिक उपयुक्त होगा। इस रीति में अग्र सूत्रों की सहायता से प्रतीपगमन गुणांकों की गणना की जाती है:

Note: x→ dx = x-A,

y→ dy = y-B

x y d

(x-5)

dy

(y-12)

dx2  dy2 dx dy
1 9 -4 -3 16 9 12
2 8 -3 -4 9 16 12
3 10 -2 -2 4 4 4
4 12 -1 0 1 0 0
5 (A) 11 (B) 0 -1 0 1 0
6 13 1 1 1 1 1
7 14 2 2 4 4 4
8 16 3 4 9 16 12
9 15 4 3 16 9 12
45 108 0 0 60 60 57

Regression Co-efficient of X on Y

bxy = 9(57) – 0(0) / 9(60) – (0)2 

        = 0.95

Regression Co-efficient of Y on X

byx = 9(57) – 0(0) / 9(60) – (0)2

        = 0.95

x̄ = Σx/n = 45/9 = 5

ȳ = Σy/n = 108/9 = 12

now,

x on y ⇒ x-x̄ = bxy (y-ȳ)

⇒ x – 5 = 0.95(y-12)

⇒ x – 5 = (0.95)y – 0.95(12)

⇒ x = (0.95)y – 11.4 + 5

⇒ x = (0.95)y – 6.4

y on x ⇒ y-ȳ = byx (x-x̄)

⇒ y – 12 = 0.95(x – 5)

⇒ y – 12 = (0.95)x – 0.95 (5)

⇒ y – 12 = (0.95)x – 4.75

⇒ y = (0.95)x – 4.75 + 12

⇒ y = (0.95)x + 7.25

(b) Calculate correlation coeff.

(c) Estimate the value of y for x = 6.2

y on x ⇒ y-ȳ = byx (x-x̄)

⇒ y = (0.95)x + 7.25

⇒ y = (0.95)6.2 + 7.25

⇒ y = 5.89 + 7.25

⇒ y = 13.14

1. Sampling Type : Random, Stratified and purposive

Sampling Type : Random, Stratified and purposive

     शोधकर्ता अपने शोध के लिए समग्र (Whole) से निश्चित संख्या में कुछ सदस्यों या वस्तुओं का चयन (Selection) कर लेता है। इस चयनित संख्या को प्रतिदर्श (Sample) कहा जाता है तथा प्रतिदर्श चयन करने की प्रविधि को प्रतिदर्शन (Sampling) कहा जाता है।

Example:

   यदि कोई शोधकर्ता किसी Universities के 5,000 छात्रों में से 50 छात्रों को अपने शोध में सम्मिलित करने के उद्देश्य से चयन कर लेता है, तो यह 50 छात्रों का चुना हुआ समूह प्रतिदर्श (Sample) कहलायेगा तथा इस प्रक्रिया को प्रतिदर्शन (Sampling) कहा जाता है।

शोध कार्य के प्रमुख पद्धतियाँ

  शोध कार्य मुख्यत: दो पद्धतियों के आधार पर किया जा सकता है:- 

(1) संगणना पद्धति (Census method)

(ii) निदर्शन पद्धति (Sampling method)

    संगणना पद्धति में अध्ययन विषय की समस्त इकाईयों का अध्ययन किया जाता है और उसी के आधार पर निष्कर्ष निकाला जाता है। जबकि निदर्शन पद्धति के अन्तर्गत सभी इकाईयों का अध्ययन न कर समग्र में से कुछ ऐसी इकाईयों को चुना जाता है जो समस्त इकाइयों का अच्छे तरीके से प्रतिनिधित्व करती है। इससे शोधकर्ता अपना ध्यान समग्र (Whole) में व्यर्थ न गवाकर कुछ पर ही केन्द्रित करता है जिससे अध्ययन विषय का गहन अध्ययन, समय और धन की बचत होती है।

⇒ न्यादर्श, प्रतिचयन, प्रतिदर्श, निदर्शन आदि शब्द समानार्थी है। इसके लिए अंग्रेजी शब्द Sampling है।

⇒ दैनिक जीवन में इस पद्धति का बहुत प्रयोग किया जाता है। जैसे- अनाज के बोरे से नमूने लेकर अनाज की जाँच करना, भोजन बनाते समय दाल या चावल के नमूने को लेकर उनकी पकने की जानकारी लेना,  रक्त (blood) की बूंद से शरीर के सभी रक्त के बारे में जानकारी प्राप्त करना इत्यादि।

   गुडे तथा हाट के अनुसार “प्रतिदर्श जैसा कि नाम से स्पष्ट है कि एक विस्तृत समूह का छोटा प्रतिनिधि है।”

   करलिंगर के अनुसार “किसी जनसंख्या या समष्टि से उसके प्रतिनिधित्व एक अंश चुन लेने को प्रतिचयन कहते है।”

  अत: न्यादर्श किसी विशाल समूह, समग्र या योग का एक अंश है जो कि समग्र का प्रतिनिधि है। अर्थात अंश की वही विशेषताएँ है जो कि सम्पूर्ण समूह या समग्र की है।

प्रतिदर्शन करते समय ध्यान में रखने वाले कारक

(factors to be kept in view During Sampling)

       Sample का चयन करते समय निम्नांकित तीन बातों पर ध्यान देना काफी महत्वपूर्ण है- 

1. जीवसंख्या का का आकार 

(Size of population):-

        यदि Population का आकार छोटा है जैसे- 200 या 300 तो ऐसी स्थिति में सामान्यतः यह देखा गया है कि Researcher सभी सदस्यों को अपने अध्ययन में शामिल कर लेता है, इस प्रकार इस स्थिति में Sampling का प्रश्न ही नहीं उठता है।

    परन्तु यदि Population का आकार बड़ा होता है जैसे- 10,000 या अधिक तो शोधकर्ता को उचित प्रतिदर्श का चयन करना आवश्यक हो जाता है।

2. प्रतिदर्शन की कीमत

(Cost of Sampling):-

      Sampling के सभी प्रक्रियाओं की लागत क्या आयेगी और वह शोधकर्ता के बजट के अनुरूप है या नहीं, यह देखना अति आवश्यक हो जाता है। शोधकर्ता को बजट के अनुसार Sampling  plan में परिवर्तन करना पड़ता है।

3. जीवसंख्या के सदस्यों की प्राप्यता

(Accessibility of members of populations):-

        Sampling करते समय तीसरी बात जो ध्यान में रखना आवश्यक है, वह यह है कि जीवसंख्या के सदस्यों का स्वरूप ऐसा होना चाहिए कि उन्हें आसानी से प्राप्त हो। यदि वे शोधकर्ता के लिए दुर्लभ है तो वैसी परिस्थिति में उन्हें प्रतिदर्श में सम्मिलित नहीं किया जा सकता है और तब शोधकर्ता को अपनी Planning में परिवर्तन करना पड़ता है।

प्रतिदर्श के आधार (Bases of Samipling)

1. समग्र की एकरूपता

(Homogeneity of whole):-

    यदि समग्र विभिन्न इकाइयों में अधिक  भिन्नताएं नहीं है तो जिन इकाइ‌यों को चुना जाएगा वे प्रतिनिधित्वपूर्ण होगी। थोड़ी बहुत भिन्नता तो मिलेगी परंतु साधारणतः यदि उनमें एकरुपता मिलेगी तो चयनित इकाईयों के आधार पर निकाला गया परिणाम विश्वसनीय एवं लाभप्रद होगा।

2. प्रतिनिधित्वपूर्ण चयन

(Representative Selection):-

    इस पद्धति के अंतर्गत समग्र में से इकाइयों को इस प्रकार चुना जाता है कि वे संपूर्ण का प्रतिनिधित्व करें। 

3. अधिक परिशुद्धता की संभावना

(Possibility of much Accuracy):- 

     निदर्शन में शत प्रतिशत परिशुद्धता लाना मुश्किल है, फिर भी यही कोशिश होनी चाहिए कि निदर्शन अधिक-से-अधिक प्रतिनिधित्वपूर्ण हो। प्रतिनिधित्वपूर्ण निदर्शन वास्तविक स्थिति का प्रतिबिंब होता है और उसके निष्कर्ष भी लगभग ठीक होते है।

    सामाजिक घटनाओं की विविधताओं के कारण निदर्शन का चुनाव यदि ठीक कर लिया जाता है तो शुद्धता की संभावना काफी अधिक रहती है।

एक अच्छे प्रतिदर्श की विशेषताएँ

(Characteristics of a good samples)

    अनुसंधान की सफलता एक अच्छे प्रतिदर्श पर निर्भर करती है। सामान्यतः एक श्रेष्ठ प्रतिदर्श में निम्नलिखित विशेषताएँ पाई

(i) जनसंख्या का प्रतिनिधित्व

(Representative of the Population)

(ii)  प्रतिदर्श का उचित आकार

(Appropriate Size of the Sample)

(iii) इकाईयों को चुने जाने की समान संभावना

(Equal chance of selection of Study units)

(iv) प्रतिचयन पक्षपात रहित होना चाहिए

(Sample Should be free from Bias)

(v) अध्ययन इकाईयों का उचित अनुपात

(Proper Ratio of Study Units)

(vi) अनुसंधान उद्देश्यों के अनुरूप

(According to The aims of Research)

(vii) समय, श्रम व धन की बचत

(Saving of Time, Labour, and money

(viii) सम्भाव्यता सिद्धांत पर आधारित

(Based on probability Theory)

(ix) अशुद्धियों से मुक्त (free from errors)

(x) तर्क पर आधारित

(Based on logic)

(xi) उच्च विश्वसनीयता स्तर

(High level of Reliability)

प्रतिदर्श के सिद्धांत अथवा सोपान

(Principles of sampling)

     प्रतिदर्श चयन करने के लिए किसी-न-किसी प्रतिचयन विधि का प्रयोग किया जाता है। प्रतिचयन सफलतापूर्वक तभी किया जा सकता है जब शोधकर्ता को प्रतिचयन पद्धतियों का आवश्यक ज्ञान हो या उसने उस क्षेत्र में कोई प्रशिक्षण लिया हो। प्रतिदर्श का चुनाव करने के लिए निम्नलिखित पदों या सिद्धांतों का अनुसरण किया जाता है-

⇒ अध्ययन उद्देश्यों का परिभाषीकरण

(Defining the objectives of the Study)

⇒  समष्टि को स्पष्ट करना

(Defining the wholes)

⇒ स्रोत सूची (Source list)

⇒ प्रतिदर्श की इकाईयाँ निर्धारित करना

(Determination of Sample Units)

⇒ प्रतिदर्श के आकार का निर्धारण

(Determination of Sample Size)

⇒ अर्थपूर्ण एवं आवश्यक आंकडों का चयन

(Selection of meaningful and essential Data)

⇒ आवश्यक शुद्धता की मात्रा का पूर्ण निर्धारण

(Predetermination of the degree of the Required precision)

⇒ मापन विधि का परिभाषीकरण

(Defining the method of measurement)

⇒ निर्देश सूची को बनाना

(Construction of Direction list)

प्रतिचयन विधि का चयन

(Selection of Sampling technique)

⇒ पूर्व परीक्षण (Pre-testing)

⇒ अध्ययन क्षेत्र का सफल संगठन

(Successful organisation of field work)

⇒ आँकड़ों का विश्लेषण तथा सारांश

(Analysis and summary of Data)

न्यादर्श के प्रकार / पद्धतियाँ एवं तकनीक

(Method and Technique of sampling)

     न्यादर्श के चयन की प्रमुख पद्धतियाँ निम्न प्रकार से है-

निदर्शन के प्रकार
Probability or Random↓ Non Probability or Non Random↓
1. Simple Random Sampling

साधारण दैव (संयोग) निदर्शन

1. Purposive / Judgement Sampling

उद्देश्यपूर्ण निदर्शन

2. Systematic Sampling

व्यवस्थित निदर्शन

2. Convenience Sampling

सुविधाजनक निदर्शन

3. Stratified Sampling

वर्गीय निदर्शन

3. Quota Sampling

कोटा निदर्शन

4. Cluster Sampling

क्लस्टर  निदर्शन

4. Panel Sampling

पैनल निदर्शन

5. Area Sampling

क्षेत्रीय निदर्शन

5. Snowball Sampling

स्नोबॉल निदर्शन
6. Multi Stage Sampling

बहुस्तरीय निदर्शन


1. दैव (संयोग) निदर्शन पद्धति

(Random Sampling method):-

       इस पद्धति के द्वारा प्रतिदर्श चुनने के लिए सर्वप्रथम संपूर्ण जनसंख्या (Total Population) की इकाईयों की सूची बनाकर उसकी प्रत्येक इकाई को समान मात्रा में महत्व देते हुए आवश्यक इकाईयों को बिना किसी भी पक्षपात के चुन लिया जाता है और ये चुनी हुई इकाइ‌याँ सम्पूर्ण जनसंख्या का प्रतिनिधित्व करती है। इस प्रतिदर्श में किसी भी इकाई को कोई विशेष महत्व नहीं दि‌या जाता है। इसके अंतर्गत प्रतिदर्श चुनने की अनेक प्रचलित विधियाँ है-

(i) लॉटरी विधि

(Lottery method)

(ii) कार्ड या टिकट विधि

(Card or Ticket Method)

(iii) नियमित अंकन प्रणाली

(Regular marking method)

(iv) अनियमित अंकन प्रणाली

(Irregular marking method)

(v) टिप्पेट प्रणाली

(Tippet method)

(vi) ग्रिड प्रणाली

(Grid method)

(vii) फिसबॉल ड्रा

(Fishbowl Draw)

मुख्य विशेषताएँ:

(i) निष्पक्षता (Impartiality):- चयन की प्रक्रिया में किसी भी व्यक्ति या वस्तु के प्रति पक्षपात नहीं होता।

(ii) समान अवसर (Equal Chance):- प्रत्येक इकाई को चयनित होने का समान अवसर प्रदान किया जाता है।

(iii) सरलता (Simplicity):- यह विधि समझने और प्रयोग करने में सरल होती है।

(iv) प्राकृतिक प्रतिनिधित्व (True Representation):- यह विधि जनसंख्या के सही प्रतिनिधित्व को सुनिश्चित करती है।

दैव निदर्शन के लाभ:

⇒ यह विधि पूर्वाग्रह-मुक्त परिणाम प्रदान करती है।

⇒ प्राप्त नमूना जनसंख्या का सही प्रतिनिधि होता है।

⇒ परिणामों की सामान्यीकरण क्षमता (Generalizability) अधिक होती है।

⇒ यह सांख्यिकीय विश्लेषण के लिए उपयुक्त होती है।

⇒ इसकी प्रक्रिया वैज्ञानिक और विश्वसनीय होती है।

दैव निदर्शन की सीमाएँ:

⇒ यदि जनसंख्या बहुत बड़ी हो, तो सभी इकाइयों की सूची तैयार करना कठिन होता है।

⇒ कभी-कभी यादृच्छिक रूप से चुने गए नमूने जनसंख्या का पूर्ण प्रतिनिधित्व नहीं कर पाते।

⇒ तकनीकी या समय-संबंधी सीमाओं के कारण इसका प्रयोग हमेशा व्यावहारिक नहीं होता।

निष्कर्ष:

    दैव निदर्शन विधि अनुसंधान में निष्पक्षता और विश्वसनीयता सुनिश्चित करने का एक सशक्त माध्यम है। यह न केवल डेटा संग्रहण की प्रक्रिया को वैज्ञानिक बनाती है, बल्कि परिणामों की सटीकता को भी बढ़ाती है। यद्यपि इसमें कुछ व्यावहारिक कठिनाइयाँ हैं, फिर भी यह शोध पद्धति में सर्वाधिक लोकप्रिय और प्रभावशाली सैम्पलिंग तकनीक मानी जाती है।


2. वर्गीय निदर्शन प्रणाली

(Stratified Sampling method):-

      वर्गीय निदर्शन प्रणाली में समग्र (Whole) को सजातीय वर्गों में बाँटकर प्रत्येक वर्ग में निश्चित संख्या में इकाईयाँ दैव निदर्शन आधार पर चयनित की जाती है। इसमें शोधकर्ता समग्र की सभी विशेषताओं के बारे में जानकारी प्राप्त कर लेता है और इसी आधार पर वह सम्पूर्ण को वर्गों में बाँट देता है। इसके बाद प्रत्येक वर्ग में से निदर्शन का चयन करता है। सभी वर्गों से अलग-अलग निदर्शन चुनकर उन्हें मिला दिया जाता है जिसके द्वारा पूर्ण निदर्शन प्राप्त हो जाता है।

   अर्थात सांख्यिकी (Statistics) और अनुसंधान (Research) में डेटा संग्रहण के लिए विभिन्न प्रकार की नमूना पद्धतियाँ अपनाई जाती हैं। इन पद्धतियों में से एक अत्यंत महत्वपूर्ण और विश्वसनीय पद्धति है स्तरीकृत नमूना पद्धति (Stratified Sampling Method)। यह एक संभाव्यता-आधारित (Probability-based) नमूना चयन की तकनीक है, जिसमें संपूर्ण जनसंख्या (Population) को विभिन्न उपसमूहों या “स्तरों” (Strata) में विभाजित किया जाता है, ताकि प्रत्येक स्तर से प्रतिनिधि नमूना प्राप्त किया जा सके।

उद्देश्य:

        इस पद्धति का प्रमुख उद्देश्य निम्नलिखित है-

⇒ नमूने में विविधता को नियंत्रित करना।

⇒ जनसंख्या के प्रत्येक उपसमूह को उचित प्रतिनिधित्व देना।

⇒ परिणामों की सटीकता (Accuracy) और विश्वसनीयता (Reliability) बढ़ाना।

प्रक्रिया (Steps):

(i) जनसंख्या की पहचान (Identification of Population):-

      पहले उस संपूर्ण जनसंख्या का निर्धारण किया जाता है, जिसके बारे में जानकारी प्राप्त करनी है।

(ii) स्तरीकरण (Stratification):-

     इसके बाद जनसंख्या को किसी समान विशेषता के आधार पर अलग-अलग स्तरों में बाँटा जाता है। उदाहरण – यदि एक विद्यालय के छात्रों का अध्ययन करना है, तो उन्हें कक्षा, लिंग या विषय के आधार पर विभाजित किया जा सकता है।

(iii) नमूना चयन (Selection of Sample):-

     प्रत्येक स्तर से यादृच्छिक या अनुपातिक संख्या में व्यक्तियों का चयन किया जाता है।

(iv) डेटा संग्रहण (Data Collection):-

       चुने गए नमूनों से आवश्यक सूचनाएँ एकत्र की जाती हैं।

(v) विश्लेषण (Analysis):-

      अंततः संपूर्ण डेटा का विश्लेषण कर निष्कर्ष निकाला जाता है।

प्रकार (Types of Stratified Sampling):

1. अनुपातिक स्तरीकृत नमूना (Proportionate Stratified Sampling):-

      इसमें प्रत्येक स्तर से उसी अनुपात में नमूना लिया जाता है, जिस अनुपात में वह संपूर्ण जनसंख्या में उपस्थित है।

2. अननुपातिक स्तरीकृत नमूना (Disproportionate Stratified Sampling):-

      इसमें प्रत्येक स्तर से समान या विशेष अनुपात में नमूना लिया जाता है, चाहे उसका वास्तविक अनुपात जनसंख्या में कुछ भी हो।

लाभ (Advantages):

⇒ यह विधि नमूना त्रुटि (Sampling Error) को कम करती है।

⇒ प्रत्येक उपसमूह का उचित प्रतिनिधित्व सुनिश्चित होता है।

⇒ विश्लेषण अधिक सटीक और विस्तृत रूप से किया जा सकता है।

⇒ छोटे-छोटे भिन्नताओं को भी पहचाना जा सकता है।

सीमाएँ (Limitations):

⇒ यह प्रक्रिया अपेक्षाकृत समय-साध्य और महँगी होती है।

⇒ स्तरों का सही निर्धारण करना कठिन होता है।

⇒ यदि स्तरों के भीतर एकरूपता न हो, तो परिणाम भ्रामक हो सकते हैं।

उदाहरण:

     मान लीजिए किसी विश्वविद्यालय में 5000 विद्यार्थी हैं — 3000 स्नातक (UG), 1500 स्नातकोत्तर (PG), और 500 शोधार्थी (PhD)। यदि शोधकर्ता 10% का नमूना लेना चाहता है, तो स्तरीकृत नमूना पद्धति के अनुसार वह 300 UG, 150 PG, और 50 PhD छात्रों को यादृच्छिक रूप से चुन लेगा। इस प्रकार प्रत्येक समूह का उचित प्रतिनिधित्व होगा।

निष्कर्ष:

     इस प्रकार स्तरीकृत नमूना पद्धति अनुसंधान में अत्यंत प्रभावी होती है क्योंकि यह जनसंख्या के सभी उपसमूहों को शामिल कर एक संतुलित और विश्वसनीय परिणाम प्रदान करती है। यद्यपि इसमें समय और संसाधनों की अधिक आवश्यकता होती है, फिर भी यह वैज्ञानिक दृष्टि से सबसे सटीक नमूना चयन विधियों में से एक मानी जाती है।


3. उद्देश्यपूर्ण न्यादर्श प्रणाली

(Purposive Sampling  या Judgmental Sampling):-

      जब अध्ययनकर्ता सम्पूर्ण समूह (Whole) में से किसी विशेष उद्देश्य से कुछ इकाईयाँ निदर्शन के रूप में चयनित करता है, उसे उद्देश्यपूर्ण सप्रयोजन या सविचार निदर्शन प्रणाली कहा जाता है। इस प्रणाली के द्वारा पक्षपात की संभावना अधिक रहती है क्योंकि शोधकर्ता अपनी इच्छानुसार इकाइयों का चयन करता है। सम्पूर्ण समूह की इकाइयों से शोधकर्ता पहले से परिचित समूह होता है। इस प्रणाली द्वारा यथासंभव उद्देश्य की पूर्ति होती है।

      अर्थात उद्देश्यपूर्ण न्यादर्श प्रणाली एक असंभाव्य (Non-probability) नमूना चयन पद्धति है, जिसमें शोधकर्ता अपने अध्ययन के उद्देश्य, अनुभव और ज्ञान के आधार पर नमूना चुनता है। इसमें जनसंख्या के प्रत्येक सदस्य को चुने जाने की समान संभावना नहीं होती, बल्कि केवल वे इकाइयाँ चयनित की जाती हैं जो शोध के उद्देश्य से सबसे अधिक संबंधित होती हैं।

      इस पद्धति का मुख्य उद्देश्य अध्ययन की प्रकृति के अनुरूप ऐसे व्यक्तियों, समूहों या क्षेत्रों का चयन करना है जो आवश्यक सूचनाएँ देने में सक्षम हों। उदाहरण के लिए, यदि शोध “कृषि में तकनीकी नवाचार” पर है, तो केवल उन्हीं किसानों का चयन किया जाएगा जिन्होंने नई तकनीक अपनाई हो।

उद्देश्यपूर्ण नमूना चयन के प्रकार:

(i) समानुपातिक उद्देश्यपूर्ण नमूना (Homogeneous Sampling):-

          इसमें एक जैसे गुणों वाले व्यक्तियों या समूहों का चयन किया जाता है।

(ii) विविधतापूर्ण नमूना (Heterogeneous Sampling):-

         इसमें विभिन्न प्रकार के लोगों या समूहों को शामिल किया जाता है ताकि विविध विचार मिल सकें।

(iii) सर्वोत्तम केस नमूना (Typical Case Sampling):-

       किसी जनसंख्या का प्रतिनिधित्व करने वाले सामान्य या विशिष्ट उदाहरणों का चयन किया जाता है।

(iv) चरम या असामान्य केस नमूना (Extreme Case Sampling):-

       इसमें विशेष रूप से उत्कृष्ट या असामान्य मामलों का अध्ययन किया जाता है।

(v) विशेषज्ञ नमूना (Expert Sampling):-

       इसमें किसी विषय के विशेषज्ञों का चयन कर उनसे जानकारी प्राप्त की जाती है।

मुख्य विशेषताएँ:

(i) विवेकाधारित चयन:-

        इस प्रणाली में नमूने का चयन शोधकर्ता के विवेक, अनुभव और अध्ययन के लक्ष्य के आधार पर किया जाता है।

(ii) उद्देश्य-निष्ठ पद्धति:-

       नमूना चयन का उद्देश्य विशेष समस्या या जनसंख्या वर्ग के व्यवहार, विचार या प्रवृत्ति का गहन अध्ययन करना होता है।

(iii) लचीलापन (Flexibility):-

      इसमें चयन की प्रक्रिया में कोई कठोर नियम नहीं होते, जिससे शोधकर्ता अपने अनुसार उपयुक्त इकाइयाँ चुन सकता है।

(iv) गुणात्मक शोध के लिए उपयोगी:-

         यह विधि विशेषतः समाजशास्त्र, मनोविज्ञान, शिक्षा और नृविज्ञान जैसे क्षेत्रों में उपयोगी होती है जहाँ गुणात्मक जानकारी का संकलन आवश्यक होता है।

(v) लागत और समय की बचत:-

       चूँकि केवल विशेष व्यक्तियों का चयन किया जाता है, इसलिए यह प्रणाली समय और संसाधन दोनों की दृष्टि से लाभकारी होती है।

लाभ (Advantages):

⇒ यह प्रणाली विशिष्ट विषय पर गहन और सटीक जानकारी प्रदान करती है।

⇒ सीमित समय और संसाधनों में भी अध्ययन संभव होता है।

⇒ शोधकर्ता को अध्ययन की दिशा और दायरे पर पूर्ण नियंत्रण रहता है।

⇒ दुर्लभ या संवेदनशील समूहों (जैसे अपराधी, मरीज, शोध विशेषज्ञ आदि) के अध्ययन में अत्यंत उपयोगी है।

सीमाएँ (Limitations):

⇒ इसमें शोधकर्ता की व्यक्तिगत पक्षपात (Bias) की संभावना अधिक होती है।

⇒ चयनित नमूना पूरी जनसंख्या का सही प्रतिनिधित्व नहीं कर पाता।

⇒ इसके निष्कर्षों का सामान्यीकरण (Generalization) कठिन होता है।

⇒ यह वैज्ञानिक दृष्टि से संभाव्यता आधारित विधियों की तुलना में कम विश्वसनीय मानी जाती है।

निष्कर्ष:

     इस प्रकार उद्देश्यपूर्ण न्यादर्श प्रणाली एक ऐसी विधि है जिसमें शोधकर्ता अपने विवेक, अनुभव और शोध उद्देश्यों के अनुरूप उपयुक्त व्यक्तियों या समूहों का चयन करता है। यह विधि विशेष रूप से गुणात्मक अनुसंधानों के लिए उपयोगी है जहाँ उद्देश्य किसी समस्या की गहराई तक जाना होता है, न कि सांख्यिकीय निष्कर्ष प्राप्त करना। हालाँकि इसमें पक्षपात की संभावना बनी रहती है, फिर भी यह सामाजिक विज्ञानों में अनुसंधान की एक अत्यंत प्रभावी और व्यावहारिक पद्धति मानी जाती है।


Sampling से संबंधित महत्वपूर्ण प्रश्नोत्तर (MCQs) – UG, PG, NET/JRF, Pre-PhD एवं Assistant Professor परीक्षाओं के लिए सरल एवं परीक्षा-उपयोगी अध्ययन सामग्री।

1. Sampling means-

निदर्शन (Sampling) का अर्थ है-

(A) Study of whole population / पूरी जनसंख्या का अध्ययन

(B) Selection of a representative part of population / जनसंख्या के एक प्रतिनिधि भाग का चयन

(C) Data analysis / डेटा विश्लेषण

(D) Questionnaire preparation / प्रश्नावली बनाना

[read more] (B) Selection of a representative part of population / जनसंख्या के एक प्रतिनिधि भाग का चयन [/read]

2. Main objective of Sampling is

Sampling का मुख्य उद्देश्य है-

(A) Save time and cost / समय एवं लागत की बचत

(B) Increase population / जनसंख्या बढ़ाना

(C) Write report / रिपोर्ट लिखना

(D) Prepare maps / मानचित्र बनाना

[read more] (A) Save time and cost / समय एवं लागत की बचत [/read]

3. Which is a Probability Sampling?

निम्नलिखित में से कौन-सा Probability Sampling है?

(A) Purposive

(B) Random

(C) Convenience

(D) Quota

[read more] (B) Random [/read]

4. Random Sampling means

Random Sampling का अर्थ है-

(A) Purposive / उद्देश्यपूर्ण

(B) Stratified / स्तरीकृत

(C) Random / यादृच्छिक

(D) Convenience / सुविधाजनक

[read more] (C) Random / यादृच्छिक [/read]

5. In Random Sampling every unit has

Random Sampling में प्रत्येक इकाई को होता है-

(A) Unequal chance / असमान अवसर

(B) Equal chance / समान अवसर

(C) No chance / कोई अवसर नहीं

(D) Fixed choice / निश्चित चयन

[read more] (B) Equal chance / समान अवसर [/read]

6. Main feature of Random Sampling

Random Sampling की मुख्य विशेषता-

(A) Unbiased selection / पक्षपात रहित चयन

(B) Researcher’s choice

(C) Small sample only

(D) Qualitative only

[read more] (A) Unbiased selection / पक्षपात रहित चयन [/read]

7. Purposive Sampling is

Purposive Sampling है-

(A) Probability

(B) Non-Probability

(C) Systematic

(D) Cluster

[read more] (B) Non-Probability [/read]

8. Purposive Sampling means

Purposive Sampling का अर्थ है-

(A) Random

(B) Stratified

(C) Purposeful / उद्देश्यपूर्ण

(D) Cluster

[read more] (C) Purposeful / उद्देश्यपूर्ण [/read]

9. Who selects sample in Purposive Sampling

Purposive Sampling में नमूना कौन चुनता है?

(A) Computer

(B) Researcher / शोधकर्ता

(C) Respondent

(D) Government

[read more] (B) Researcher / शोधकर्ता [/read]

10. Purposive Sampling is mainly used in

Purposive Sampling मुख्यतः उपयोग होती है-

(A) Qualitative research / गुणात्मक शोध

(B) Physics

(C) Chemistry

(D) Mathematics

[read more] (A) Qualitative research / गुणात्मक शोध [/read]

11. Stratified Sampling means

Stratified Sampling का अर्थ है-

(A) Random

(B) Stratified / स्तरीकृत

(C) Purposive

(D) Convenience

[read more] (B) Stratified / स्तरीकृत [/read]

12. Population is divided into

Stratified Sampling में जनसंख्या को विभाजित किया जाता है-

(A) Villages

(B) Strata / स्तर

(C) Families

(D) Districts

[read more] (B) Strata / स्तर [/read]

13. Purpose of Stratified Sampling

Stratified Sampling का उद्देश्य-

(A) Representation of all strata / सभी स्तरों का प्रतिनिधित्व

(B) Increase cost

(C) Waste time

(D) Data collection

[read more] (A) Representation of all strata / सभी स्तरों का प्रतिनिधित्व [/read]

14. Which is Non-Probability Sampling

कौन-सा Non-Probability Sampling है?

(A) Random

(B) Stratified

(C) Purposive

(D) Systematic

[read more] (C) Purposive [/read]

15. Sampling Unit is

Sampling Unit क्या है?

(A) Whole population

(B) Selected unit / चयनित इकाई

(C) Questionnaire

(D) Table

[read more] (B) Selected unit / चयनित इकाई [/read]

16. Census studies

Census Method में अध्ययन होता है-

(A) Sample

(B) Whole population / पूरी जनसंख्या

(C) Village

(D) City

[read more] (B) Whole population / पूरी जनसंख्या [/read]

17. Need of Sampling

Sampling की आवश्यकता-

(A) Save time & money

(B) Increase population

(C) Print report

(D) Mapping

[read more] (A) Save time & money [/read]

18. Biggest advantage of Random Sampling

Random Sampling का सबसे बड़ा लाभ-

(A) Less bias / कम पक्षपात

(B) High cost

(C) More time

(D) Complexity

[read more] (A) Less bias / कम पक्षपात [/read]

19. Major limitation of Purposive Sampling

Purposive Sampling का प्रमुख दोष-

(A) Bias / पक्षपात

(B) Saves time

(C) Low cost

(D) Better representation

[read more] (A) Bias / पक्षपात [/read]

20. Stratified Sampling is suitable for

Stratified Sampling उपयुक्त है-

(A) Heterogeneous population / विषम जनसंख्या

(B) Homogeneous

(C) Small sample

(D) Lab study

[read more] (A) Heterogeneous population / विषम जनसंख्या [/read]

21. Sampling Error relates to

Sampling Error संबंधित है-

(A) Sample selection

(B) Map

(C) Report

(D) Book

[read more] (A) Sample selection [/read]

22. Feature of Probability Sampling

Probability Sampling की विशेषता-

(A) Equal probability

(B) Researcher’s choice

(C) Convenience

(D) Experience

[read more] (A) Equal probability [/read]

23. Purposive Sampling is based on

Purposive Sampling आधारित है-

(A) Researcher’s judgement

(B) Lottery

(C) Computer

(D) Chance

[read more] (A) Researcher’s judgement [/read]

24. When is Stratified Sampling used?

Stratified Sampling कब उपयोग होती है?

(A) Population divided into strata

(B) Small population

(C) No data

(D) No questionnaire

[read more] (A) Population divided into strata [/read]

25. Which is not Probability Sampling?

कौन-सा Probability Sampling नहीं है?

(A) Random

(B) Stratified

(C) Purposive

(D) Systematic

[read more] (C) Purposive [/read]

26. Objective of Sampling

Sampling का उद्देश्य-

(A) Representative sample

(B) Increase population

(C) Increase time

(D) Reduce data

[read more] (A) Representative sample [/read]

27. Most unbiased sampling

सबसे निष्पक्ष Sampling-

(A) Purposive

(B) Random

(C) Convenience

(D) Judgment

[read more] (B) Random [/read]

28. Advantage of Stratified Sampling

Stratified Sampling का लाभ-

(A) Representation of all strata

(B) More bias

(C) More time

(D) Qualitative only

[read more] (A) Representation of all strata [/read]

29. Purposive Sampling is useful in

Purposive Sampling उपयोगी है-

(A) Case study & qualitative research

(B) Census

(C) Math model

(D) Lab

[read more] (A) Case study & qualitative research [/read]

30. Which is not a sampling type

कौन-सा Sampling का प्रकार नहीं है?

(A) Random

(B) Stratified

(C) Purposive

(D) Histogram

[read more] (D) Histogram [/read]
error: