Category RESEARCH METHODOLOGY

9. Review of Literature / साहित्य समीक्षा

Review of Literature 

साहित्य समीक्षा

Review of Literature

परिचय:

   साहित्य समीक्षा (Review of Literature) किसी भी शोध कार्य का एक अत्यंत महत्वपूर्ण भाग है। यह शोधकर्ता को अपने विषय से संबंधित पूर्व में किए गए अध्ययनों, सिद्धांतों, अवधारणाओं तथा निष्कर्षों की जानकारी प्रदान करती है। साहित्य समीक्षा के माध्यम से शोधकर्ता यह समझता है कि उसके शोध विषय पर अब तक क्या कार्य किया जा चुका है, किन पहलुओं का अध्ययन किया गया है तथा किन क्षेत्रों में अभी भी शोध की आवश्यकता है। दूसरे शब्दों में, साहित्य समीक्षा शोध की पृष्ठभूमि तैयार करती है और शोध समस्या को वैज्ञानिक आधार प्रदान करती है।

     भूगोल में साहित्य समीक्षा का विशेष महत्व है क्योंकि यह विषय प्राकृतिक एवं मानव दोनों प्रकार की घटनाओं का अध्ययन करता है। किसी क्षेत्र, संसाधन, जनसंख्या, पर्यावरण, नगरीकरण या क्षेत्रीय विकास से संबंधित शोध करने से पहले उस विषय पर उपलब्ध साहित्य का अध्ययन आवश्यक होता है।

साहित्य समीक्षा की परिभाषा:

जॉन डब्ल्यू. बेस्ट (John W. Best) के अनुसार,

      “साहित्य समीक्षा किसी विषय से संबंधित उपलब्ध ज्ञान, सिद्धांतों और शोध अध्ययनों का व्यवस्थित एवं आलोचनात्मक अध्ययन है।”

केर्लिंगर (Kerlinger) के अनुसार,

    “साहित्य समीक्षा पूर्व में किए गए शोध कार्यों का विश्लेषण एवं मूल्यांकन है, जिससे वर्तमान शोध की दिशा निर्धारित की जाती है।”

साहित्य समीक्षा के उद्देश्य:

1. शोध समस्या की पहचान करना:-

   साहित्य समीक्षा के माध्यम से शोधकर्ता अपने विषय की वर्तमान स्थिति को समझता है तथा शोध समस्या को स्पष्ट रूप से परिभाषित कर सकता है।

2. पूर्व शोधों की जानकारी प्राप्त करना:-

    यह शोधकर्ता को बताती है कि संबंधित विषय पर अब तक क्या-क्या अध्ययन किए जा चुके हैं तथा उनके प्रमुख निष्कर्ष क्या हैं।

3. शोध अंतराल (Research Gap) की पहचान:-

     साहित्य समीक्षा का सबसे महत्वपूर्ण उद्देश्य यह जानना है कि किन विषयों पर पर्याप्त शोध नहीं हुआ है और कहाँ नए अध्ययन की आवश्यकता है।

4. सैद्धांतिक आधार प्रदान करना:

     यह शोधकर्ता को उपयुक्त सिद्धांतों, मॉडलों तथा अवधारणाओं के चयन में सहायता प्रदान करती है।

5. शोध पद्धति के चयन में सहायता:-

      पूर्व अध्ययनों का अध्ययन करके शोधकर्ता उपयुक्त अनुसंधान विधि, डेटा संग्रहण तकनीक एवं विश्लेषण पद्धति का चयन कर सकता है।

साहित्य समीक्षा के स्रोत (Sources of Literature Review):

1. पाठ्य-पुस्तकें (Textbooks)

2.  सन्दर्भ पुस्तकें (Reference Books)

3. विश्वकोश (Encyclopedias)

4. वार्षिकी पुस्तकें (Year Books)

5. प्रकाशित शोध प्रबंध (Published Thesis)

6. अप्रकाशित शोधग्रंथ (Unublished Theses)

7. सावधिक पत्रिकाएं (Journals / Periodicals)

8. सारांश पुस्तिका (Abstracts / Abstract Journals)

9. शब्दकोश (Dictionaries)

10. निर्देशिका (Directories)

11. ग्रन्थ सूची (Bibliographies)

12. अभिसूचिकाएं (Indexes / Indexing Services)

13. जीवन वृतांत (Bibliograpy)

14. कम्पूटर सामग्री (Computer-Based Resources / Electronic Resources / Digital Resources)

15. कार्यालय अभिलेख (Official Records / Office Records)

16. लघु पुस्तिकाएं (Pamphlets / Booklets)

17. समाचार पत्र (Newspapers)

भूगोल में साहित्य समीक्षा का महत्व:

1. विषय की व्यापक समझ:-

     भूगोल में किसी क्षेत्र या समस्या की ऐतिहासिक एवं वर्तमान स्थिति को समझने में साहित्य समीक्षा सहायक होती है।

2. सिद्धांतों और मॉडलों का ज्ञान:-

      केंद्रीय स्थान सिद्धांत, जनसंख्या संक्रमण सिद्धांत, क्षेत्रीय विकास मॉडल आदि की जानकारी साहित्य समीक्षा से प्राप्त होती है।

3. क्षेत्रीय अध्ययन में सहायता:-

    किसी विशेष क्षेत्र के भौतिक, सामाजिक तथा आर्थिक पहलुओं की जानकारी उपलब्ध साहित्य से प्राप्त की जा सकती है।

4. डेटा एवं पद्धति का चयन:-

    पूर्व अध्ययनों से डेटा स्रोत, मानचित्रण तकनीक, GIS, Remote Sensing तथा सांख्यिकीय विधियों की जानकारी मिलती है।

साहित्य समीक्षा की प्रक्रिया:

1. शोध विषय का चयन:-

     सबसे पहले शोध विषय एवं उद्देश्य स्पष्ट किए जाते हैं।

2. साहित्य का संग्रह:-

     पुस्तकों, शोध पत्रों, रिपोर्टों एवं ऑनलाइन स्रोतों से संबंधित सामग्री एकत्र की जाती है।

3. साहित्य का वर्गीकरण:-

     संग्रहित साहित्य को विषय, समय, क्षेत्र या पद्धति के आधार पर वर्गीकृत किया जाता है।

4. आलोचनात्मक विश्लेषण:-

     प्रत्येक अध्ययन की पद्धति, निष्कर्ष एवं सीमाओं का मूल्यांकन किया जाता है।

5. शोध अंतराल की पहचान:-

     पूर्व अध्ययनों में मौजूद कमियों तथा अनुत्तरित प्रश्नों की पहचान की जाती है।

6. साहित्य समीक्षा का लेखन:-

      अंत में उपलब्ध अध्ययनों को तार्किक एवं क्रमबद्ध रूप में प्रस्तुत किया जाता है।

साहित्य समीक्षा की विशेषताएँ:

  • व्यवस्थित एवं वैज्ञानिक होती है।
  • वस्तुनिष्ठ (Objective) होती है।
  • आलोचनात्मक विश्लेषण पर आधारित होती है।
  • शोध समस्या को स्पष्ट करती है।
  • नए शोध की दिशा निर्धारित करती है।
  • शोध की विश्वसनीयता बढ़ाती है।

साहित्य समीक्षा लिखते समय सावधानियाँ:

  1. केवल प्रासंगिक साहित्य का चयन करें।
  2. नवीनतम शोध अध्ययनों को प्राथमिकता दें।
  3. स्रोतों का सही संदर्भ (Citation) दें।
  4. साहित्य का केवल वर्णन न करें, उसका विश्लेषण भी करें।
  5. शोध अंतराल को स्पष्ट रूप से दर्शाएँ।
  6. साहित्य समीक्षा को तार्किक क्रम में प्रस्तुत करें।

निष्कर्ष:

   साहित्य समीक्षा किसी भी शोध कार्य की आधारशिला होती है। यह शोधकर्ता को विषय की पृष्ठभूमि, पूर्व अध्ययनों, सिद्धांतों तथा शोध अंतराल की जानकारी प्रदान करती है। भूगोल जैसे बहुआयामी विषय में साहित्य समीक्षा न केवल शोध की दिशा निर्धारित करती है, बल्कि उपयुक्त पद्धति, डेटा स्रोत तथा विश्लेषण तकनीकों के चयन में भी सहायता करती है। इसलिए एक प्रभावी एवं वैज्ञानिक शोध के लिए साहित्य समीक्षा का गहन एवं व्यवस्थित अध्ययन अत्यंत आवश्यक है।

Literature Review (साहित्य समीक्षा) से संबंधित 40+ महत्वपूर्ण प्रश्नोत्तर, MCQs एवं परीक्षा उपयोगी नोट्स – NET/JRF, Pre-PhD, Assistant Professor, BPSC एवं PG विद्यार्थियों के लिए।

1. साहित्य समीक्षा का मुख्य उद्देश्य क्या है?

What is the main objective of a Literature Review?

(A) डेटा संग्रह करना / Collect data

(B) पूर्व शोधों का अध्ययन करना / Study previous research

(C) प्रश्नावली बनाना / Prepare questionnaire

(D) नमूना चयन करना / Select sample

[read more] (B) पूर्व शोधों का अध्ययन करना / Study previous research [/read]

2. Literature Review शोध का कौन-सा भाग है?

Which stage of research includes Literature Review?

(A) अंतिम चरण / Final stage

(B) प्रारंभिक चरण / Initial stage

(C) डेटा विश्लेषण / Data analysis

(D) निष्कर्ष / Conclusion

[read more] (B) प्रारंभिक चरण / Initial stage [/read]

3. Literature Review शोधकर्ता को क्या पहचानने में सहायता करता है?

Literature Review helps identify:

(A) बजट / Budget

(B) Research Gap

(C) Sample Size

(D) Questionnaire

[read more] (B) Research Gap [/read]

4. Literature Review का प्रमुख स्रोत कौन-सा है?

Major source of Literature Review?

(A) समाचार पत्र / Newspaper

(B) Research Articles

(C) विज्ञापन / Advertisement

(D) Poster

[read more] (B) Research Articles [/read]

5. प्राथमिक स्रोत कौन है?

Which is a Primary Source?

(A) Encyclopedia

(B) Thesis

(C) Dictionary

(D) Textbook

[read more] (B) Thesis [/read]

6. विश्वकोश किस प्रकार का स्रोत है?

Encyclopedia is a:

(A) Primary

(B) Secondary

(C) Tertiary

(D) None

[read more] (B) Secondary [/read]

7. Bibliography का अर्थ है?

Bibliography means:

(A) Dictionary

(B) Bibliography/ग्रन्थ सूची

(C) Directory

(D) Index

[read more] (B) Bibliography/ग्रन्थ सूची [/read]

8. Research Gap का पता किससे चलता है?

Research Gap is identified through:

(A) Data Collection

(B) Literature Review

(C) Interview

(D) Questionnaire

[read more] (B) Literature Review [/read]

9. Literature Review किस प्रकार का अध्ययन है?

Literature Review is:

(A) Critical

(B) Descriptive only

(C) Experimental

(D) Statistical

[read more] (A) Critical [/read]

10. Literature Review किसके चयन में सहायता करता है?

It helps in selecting:

(A) Methodology

(B) Sample

(C) Tools

(D) All of these

[read more] (D) All of these [/read]

11. शोध में Literature Review क्यों आवश्यक है?

Why is Literature Review necessary?

(A) Time pass

(B) Understand previous studies

(C) Print questionnaire

(D) Decorate report

[read more] (B) Understand previous studies [/read]

12. Review of Literature का अर्थ है?

Review of Literature means:

(A) Write a book

(B) Systematic study of previous literature

(C) Read news

(D) Publish article

[read more] (B) Systematic study of previous literature [/read]

13. Literature Review का पहला चरण?

First step of Literature Review?

(A) Conclusion

(B) Topic selection

(C) Analysis

(D) Publication

[read more] (B) Topic selection [/read]

14. Literature Review में किन स्रोतों का उपयोग?

Sources used in Literature Review?

(A) Books

(B) Articles

(C) Theses

(D) All

[read more] (D) All [/read]

15. नवीनता ज्ञात करने में सहायक?

Helps identify originality?

(A) Questionnaire

(B) Literature Review

(C) Interview

(D) Observation

[read more] (B) Literature Review [/read]

16. सैद्धांतिक पृष्ठभूमि किससे बनती है?

Theoretical background comes from:

(A) Conclusion

(B) Literature Review

(C) Data

(D) Statistics

[read more] (B) Literature Review [/read]

17. तृतीयक स्रोत कौन-सा है?

Which is a tertiary source?

(A) Article

(B) Thesis

(C) Index

(D) Govt report

[read more] (C) Index [/read]

18. Research Article कहाँ प्रकाशित होता है?

Research article is published in:

(A) Newspaper

(B) Journal

(C) Novel

(D) Magazine

[read more] (B) Journal [/read]

19. Literature Review का प्रमुख लाभ?

Major advantage?

(A) Increase time

(B) Sets research direction

(C) Increase cost

(D) Reduce data

[read more] (B) Sets research direction [/read]

20. Literature Review का मुख्य उद्देश्य?

Main objective?

(A) Analyze previous studies

(B) Prepare questionnaire

(C) Collect data

(D) Publish report

[read more] (A) Analyze previous studies [/read]

21. Literature Review किससे संबंधित है?

Related to:

(A) Published & unpublished research

(B) Newspapers

(C) Internet only

(D) Books only

[read more] (A) Published & unpublished research [/read]

22. Citation का उद्देश्य?

Purpose of citation?

(A) Decoration

(B) Give credit

(C) Increase words

(D) Lengthen report

[read more] (B) Give credit [/read]

23. द्वितीयक स्रोत कौन है?

Which is a secondary source?

(A) Textbook

(B) Thesis

(C) Survey Report

(D) Interview

[read more] (A) Textbook [/read]

24. Literature Review कब करना चाहिए?

When should it be done?

(A) After research

(B) Before research

(C) After viva

(D) After publication

[read more] (B) Before research [/read]

25. Literature Review में क्या शामिल नहीं होता?

What is not included?

(A) Previous studies

(B) Theories

(C) Concepts

(D) Personal opinion

[read more] (D) Personal opinion [/read]

26. Literature Review किसे मजबूत बनाता है?

It strengthens:

(A) Research background

(B) Questionnaire

(C) Budget

(D) Schedule

[read more] (A) Research background [/read]

27. Research Gap का अर्थ?

Meaning of Research Gap?

(A) Conclusion

(B) Unexplored area

(C) Data collection

(D) Sample size

[read more] (B) Unexplored area [/read]

28. Literature Review किन स्रोतों पर आधारित होना चाहिए?

Should be based on:

(A) Authentic sources

(B) Rumours

(C) Social media

(D) Ads

[read more] (A) Authentic sources [/read]

29. Literature Review का अंतिम उद्देश्य?

Ultimate objective?

(A) Scientific basis

(B) Decoration

(C) Increase pages

(D) Tables

[read more] (A) Scientific basis [/read]

30. Research Methodology में Literature Review का स्थान?

Place in Research Methodology?

(A) One of the most important chapters

(B) Appendix

(C) After conclusion

(D) After references

[read more] (A) One of the most important chapters [/read]

31. निम्नलिखित में से कौन-सा कथन साहित्य समीक्षा के उद्देश्य एवं महत्व को सर्वाधिक उचित रूप से व्यक्त करता है?

Which statement best explains the purpose and importance of Literature Review?

(A) यह केवल पूर्व शोधों की सूची तैयार करने की प्रक्रिया है / It only lists previous studies.

(B) यह केवल संदर्भ एकत्र करने में सहायता करती है / It only helps collect references.

(C) यह पूर्व शोधों का आलोचनात्मक विश्लेषण कर Research Gap, theoretical base एवं methodology की पहचान करती है / It critically analyzes previous studies to identify the research gap, theoretical base and methodology.

(D) इसका उद्देश्य केवल अध्याय बढ़ाना है / It only increases the number of chapters.

[read more] (C) यह पूर्व शोधों का आलोचनात्मक विश्लेषण कर Research Gap, theoretical base एवं methodology की पहचान करती है / It critically analyzes previous studies to identify the research gap, theoretical base and methodology. [/read]

32. यदि शोधकर्ता पूर्व शोधों का अध्ययन कर Research Gap पहचानता है, तो यह किसका उदाहरण है?

If a researcher identifies a research gap after reviewing previous studies, this is an example of:

(A) Data Analysis

(B) Literature Review identifying Research Gap

(C) Hypothesis Testing

(D) Statistical Analysis

[read more] (B) Literature Review identifying Research Gap [/read]

33. साहित्य समीक्षा की वैज्ञानिक विशेषताओं का सर्वोत्तम संयोजन कौन-सा है?

Which is the best combination of scientific characteristics of Literature Review?

(A) वस्तुनिष्ठता, आलोचनात्मक विश्लेषण, प्रासंगिक स्रोत एवं Research Gap / Objectivity, critical analysis, relevant sources and research gap

(B) केवल पुस्तकों का सारांश / Only summary of books

(C) केवल इंटरनेट स्रोत / Only internet sources

(D) व्यक्तिगत विचार / Personal opinions

[read more] (A) वस्तुनिष्ठता, आलोचनात्मक विश्लेषण, प्रासंगिक स्रोत एवं Research Gap / Objectivity, critical analysis, relevant sources and research gap [/read]

34. यदि साहित्य समीक्षा केवल वर्णनात्मक हो और आलोचनात्मक विश्लेषण न हो, तो प्रमुख कमी क्या होगी?

If a literature review is only descriptive and lacks critical analysis, what is its major weakness?

(A) Citation error

(B) Research Gap स्पष्ट नहीं होगा / Research gap will not be identified

(C) Thesis rejected

(D) Statistical error

[read more] (B) Research Gap स्पष्ट नहीं होगा / Research gap will not be identified [/read]

35. साहित्य समीक्षा के स्रोतों का सही वर्गीकरण कौन-सा है?

Which is the correct classification of literature sources?

(A) Research Article–Primary; Textbook–Secondary; Index–Tertiary

(B) Newspaper–Primary; Dictionary–Primary; Encyclopedia–Tertiary

(C) Textbook–Primary; Thesis–Secondary

(D) Only research articles

[read more] (A) Research Article–Primary; Textbook–Secondary; Index–Tertiary [/read]

36. ग्रामीण क्षेत्रों पर अध्ययन का अभाव किसे दर्शाता है?

Lack of studies on rural areas indicates:

(A) Sampling Error

(B) Research Gap

(C) Pilot Survey

(D) Null Hypothesis

[read more] (B) Research Gap [/read]

37. साहित्य समीक्षा की सबसे महत्वपूर्ण भूमिका क्या है?

What is the most important role of Literature Review?

(A) औपचारिकता / Formality

(B) पृष्ठभूमि, सिद्धांत, पद्धति एवं भविष्य की दिशा प्रदान करना / Providing background, theories, methodology and future direction

(C) निष्कर्ष के बाद लिखना

(D) गुणवत्ता से असंबंधित

[read more] (B) पृष्ठभूमि, सिद्धांत, पद्धति एवं भविष्य की दिशा प्रदान करना / Providing background, theories, methodology and future direction [/read]

38. केवल पुराने स्रोतों के उपयोग की सबसे बड़ी कमी क्या है?

What is the major drawback of using only old sources?

(A) Language error

(B) Updated knowledge का अभाव / Lack of updated knowledge

(C) Statistical error

(D) Short reference list

[read more] (B) Updated knowledge का अभाव / Lack of updated knowledge [/read]

39. शोध की गुणवत्ता बढ़ाने के लिए कौन-सी प्रक्रिया सर्वोत्तम है?

Which process best improves research quality?

(A) केवल ब्लॉग / Only blogs

(B) केवल एक पुस्तक / One book

(C) प्रामाणिक स्रोतों का आलोचनात्मक विश्लेषण / Critical analysis of authentic sources

(D) व्यक्तिगत अनुभव

[read more] (C) प्रामाणिक स्रोतों का आलोचनात्मक विश्लेषण / Critical analysis of authentic sources [/read]

40. यदि साहित्य समीक्षा के आधार पर शोध समस्या, उद्देश्य एवं पद्धति तय की जाए, तो यह किस भूमिका को दर्शाता है?

If research problem, objectives and methodology are framed through literature review, it indicates:

(A) केवल संदर्भ सूची / Only bibliography

(B) वैज्ञानिक एवं सैद्धांतिक आधारशिला / Scientific and theoretical foundation

(C) केवल डेटा संग्रह

(D) केवल निष्कर्ष

[read more] (B) वैज्ञानिक एवं सैद्धांतिक आधारशिला / Scientific and theoretical foundation [/read]

3. Centro- Graphic Techniques- Histogram and Frequency Polygon / केन्द्र-ग्राफिक तकनीक- हिस्टोग्राम एवं आवृत्ति बहुभुज

Centro- Graphic Techniques- Histogram and Frequency Polygon

केन्द्र-ग्राफिक तकनीक- हिस्टोग्राम एवं आवृत्ति बहुभुज

परिचय (Introduction):

    भूगोल और सांख्यिकी में डेटा को समझने और प्रस्तुत करने के लिए विभिन्न ग्राफिक तकनीकों का उपयोग किया जाता है। इन्हीं में से एक महत्वपूर्ण तकनीक है Centro-Graphic Techniques, जिसका उद्देश्य आंकड़ों के वितरण (Distribution) को ग्राफ के माध्यम से स्पष्ट करना है।

इस तकनीक के अंतर्गत मुख्य रूप से हिस्टोग्राम (Histogram) और आवृत्ति बहुभुज (Frequency Polygon) का उपयोग किया जाता है। ये दोनों विधियाँ आंकड़ों के वितरण, प्रवृत्ति और फैलाव को समझने में अत्यंत उपयोगी हैं।

हिस्टोग्राम

(Histogram)

परिचय: 

     हिस्टोग्राम एक महत्वपूर्ण ग्राफिक विधि है जिसका उपयोग सांख्यिकी और भूगोल में डेटा के वितरण को प्रदर्शित करने के लिए किया जाता है। इसमें वर्ग-अंतराल (Class Interval) को क्षैतिज अक्ष (X-axis) पर तथा आवृत्ति (Frequency) को ऊर्ध्वाधर अक्ष (Y-axis) पर दर्शाया जाता है।

    प्रत्येक वर्ग के लिए आयत (Rectangles) बनाए जाते हैं, जिनकी ऊँचाई उस वर्ग की आवृत्ति के अनुसार होती है। हिस्टोग्राम विशेष रूप से सतत श्रेणी (Continuous Series) के लिए उपयोगी होता है। इसके माध्यम से आंकड़ों के फैलाव, प्रवृत्ति तथा बहुलक का पता लगाना आसान हो जाता है, जिससे विश्लेषण सरल और प्रभावी बनता है।

परिभाषा (Definition):

   हिस्टोग्राम एक ऐसा ग्राफ है जिसमें वर्ग-अंतराल (Class Interval) को X-अक्ष पर और आवृत्ति (Frequency) को Y-अक्ष पर दर्शाया जाता है। इसमें आयताकार (Rectangles) बनाए जाते हैं, जिनकी ऊँचाई आवृत्ति के अनुसार होती है।

विशेषताएँ (Characteristics):

(i) आयताकार आकृति (Rectangular Form):-

     हिस्टोग्राम आयतों (Rectangles) से बना होता है, जहाँ प्रत्येक आयत एक वर्ग-अंतराल (Class Interval) का प्रतिनिधित्व करता है। इससे डेटा का वितरण स्पष्ट दिखाई देता है।

(ii) आयतों के बीच कोई अंतर नहीं (No Gap):-

    हिस्टोग्राम में सभी आयत आपस में जुड़े होते हैं, क्योंकि यह सतत (Continuous) श्रेणी को दर्शाता है। यह इसकी प्रमुख पहचान है।

(iii) क्षैतिज अक्ष पर वर्ग-अंतराल (X-axis):-

     X-axis पर वर्ग-अंतराल (जैसे 0–10, 10–20 आदि) दर्शाए जाते हैं, जो डेटा के समूहों को दिखाते हैं।

(iv) ऊर्ध्वाधर अक्ष पर आवृत्ति (Y-axis):-

     Y-axis पर आवृत्ति (Frequency) दर्शाई जाती है, जिससे प्रत्येक वर्ग में आने वाले मानों की संख्या पता चलती है।

(v) आयत की ऊँचाई आवृत्ति के अनुसार:-

     प्रत्येक आयत की ऊँचाई उस वर्ग की आवृत्ति के समानुपाती होती है, यानी अधिक आवृत्ति → अधिक ऊँचाई।

(vi) आयत की चौड़ाई वर्ग-अंतराल के बराबर:-

     हर आयत की चौड़ाई समान होती है, जो वर्ग-अंतराल की लंबाई को दर्शाती है।

(vii) सतत श्रेणी के लिए उपयुक्त:-

    हिस्टोग्राम मुख्यतः Continuous Series के लिए उपयोग किया जाता है, जहाँ वर्ग-अंतराल जुड़े होते हैं।

(viii) डेटा के वितरण को स्पष्ट करता है:-

    यह दिखाता है कि डेटा किस प्रकार फैला हुआ है—जैसे सममित (Symmetrical), विकृत (Skewed) आदि।

(ix) बहुलक ज्ञात करने में सहायक:-

    हिस्टोग्राम के माध्यम से बहुलक (Mode) का अनुमान आसानी से लगाया जा सकता है।

(x) सरल एवं दृश्यात्मक प्रस्तुति:-

   यह जटिल आंकड़ों को सरल और आकर्षक तरीके से प्रस्तुत करता है, जिससे समझना आसान हो जाता है।

हिस्टोग्राम बनाने की विधि (Steps):

     हिस्टोग्राम बनाने के लिए निम्नलिखित चरण क्रमबद्ध तरीके से अपनाए जाते हैं:

✍️ आंकड़ों को व्यवस्थित करें

      सबसे पहले दिए गए आंकड़ों को सतत श्रेणी (Continuous Series) में व्यवस्थित करें। यदि डेटा असतत (Discrete) हो, तो उसे वर्ग-अंतराल में बदलें।

✍️ वर्ग-अंतराल (Class Interval) निर्धारित करें

    आंकड़ों को समान अंतराल वाले वर्गों (जैसे 0–10, 10–20, 20–30) में विभाजित करें। सभी वर्गों की चौड़ाई (Class Width) समान होनी चाहिए।

✍️ आवृत्ति (Frequency) ज्ञात करें

     प्रत्येक वर्ग-अंतराल में आने वाले मानों की संख्या गिनकर उनकी आवृत्ति निर्धारित करें।

✍️ अक्ष (Axes) बनाएं

  • X-अक्ष (Horizontal Axis) पर वर्ग-अंतराल अंकित करें।
  • Y-अक्ष (Vertical Axis) पर आवृत्ति (Frequency) अंकित करें।

    स्केल (Scale) का चयन इस प्रकार करें कि पूरा ग्राफ स्पष्ट और संतुलित दिखे।

✍️ आयत (Rectangles) बनाएं

    प्रत्येक वर्ग-अंतराल के लिए आयत बनाएं:

  • आयत की चौड़ाई = वर्ग-अंतराल
  • आयत की ऊँचाई = आवृत्ति

    ध्यान रखें कि सभी आयत आपस में जुड़े हों, बीच में कोई गैप न हो।

✍️ असमान वर्ग-अंतराल का समायोजन (यदि आवश्यक हो)

    यदि वर्ग-अंतराल समान नहीं हैं, तो आवृत्ति घनत्व (Frequency Density) का उपयोग करें:

Frequency Density = Frequency/Class Width

   और उसी के अनुसार आयत की ऊँचाई निर्धारित करें।

उदाहरण:

(Marks of Students)

अंक (Marks) आवृत्ति (Frequency)
0–10 5
10–20 8
20–30 12
30–40 7
40–50 3

चरण 1: अक्ष बनाना

⇒ X-अक्ष पर वर्ग-अंतराल (0–10, 10–20, …)

⇒ Y-अक्ष पर आवृत्ति (5, 8, 12, 7, 3)

चरण 2: आयत बनाना

प्रत्येक वर्ग के लिए आयत बनाएं:

0–10 → ऊँचाई = 5

10–20 → ऊँचाई = 8

20–30 → ऊँचाई = 12

30–40 → ऊँचाई = 7

40–50 → ऊँचाई = 3

नोट: सभी आयत आपस में जुड़े होंगे (कोई गैप नहीं होगा)।

चरण 3: ग्राफ की व्याख्या

⇒ सबसे अधिक आवृत्ति 20–30 वर्ग में है → यह बहुलक वर्ग (Modal Class) है।

⇒ इससे पता चलता है कि अधिकतर छात्रों के अंक 20–30 के बीच हैं।

Centro- Graphic Techniquesउपयोग (Uses):

✍️  डेटा के वितरण को समझने में

✍️  बहुलक (Mode) ज्ञात करने में

✍️  आर्थिक एवं जनसंख्या विश्लेषण में

आवृत्ति बहुभुज

(Frequency Polygon)

परिचय: 

  आवृत्ति बहुभुज एक महत्वपूर्ण ग्राफिक विधि है जिसका उपयोग सांख्यिकी और भूगोल में डेटा के वितरण को रेखीय रूप में प्रदर्शित करने के लिए किया जाता है। इसमें वर्ग-अंतराल के मध्य बिंदुओं (Mid-points) को X-अक्ष पर तथा उनकी आवृत्तियों को Y-अक्ष पर अंकित किया जाता है। इन बिंदुओं को सीधी रेखाओं से जोड़कर एक बहुभुज आकृति बनाई जाती है, जिसे आवृत्ति बहुभुज कहते हैं। यह विधि विशेष रूप से विभिन्न वितरणों की तुलना करने में उपयोगी होती है। इसके माध्यम से डेटा की प्रवृत्ति, फैलाव और पैटर्न को आसानी से समझा जा सकता है।

परिभाषा (Definition):

    आवृत्ति बहुभुज एक ऐसा ग्राफ है जिसमें वर्ग-अंतराल के मध्य बिंदु (Mid-point) को X-अक्ष पर तथा आवृत्ति को Y-अक्ष पर लेकर बिंदुओं को मिलाकर रेखा बनाई जाती है।

विशेषताएँ (Characteristics):

यह रेखीय ग्राफ (Line Graph) होता है।

✍️  बिंदुओं को सीधी रेखा से जोड़कर बहुभुज बनाया जाता है।

✍️  यह हिस्टोग्राम से भी बनाया जा सकता है।

✍️  दो या अधिक वितरणों की तुलना में उपयोगी होता है।

बनाने की विधि (Steps):

✍️  प्रत्येक वर्ग का मध्य बिंदु (Mid-point) निकालें।

✍️  X-अक्ष पर मध्य बिंदु और Y-अक्ष पर आवृत्ति अंकित करें।

✍️  बिंदुओं को मिलाकर रेखा बनाएं।

✍️  प्रारंभ और अंत में शून्य आवृत्ति के बिंदु जोड़ें।

उदाहरण-

(Marks of Students)

अंक (Marks) आवृत्ति (Frequency)
0–10 5
10–20 8
20–30 12
30–40 7
40–50 3

चरण 1: मध्य बिंदु (Mid-point) निकालें

वर्ग-अंतराल आवृत्ति मध्य बिंदु
0–10 5 5
10–20 8 15
20–30 12 25
30–40 7 35
40–50 3 45

चरण 2: ग्राफ बनाना

⇒ X-अक्ष पर मध्य बिंदु (5, 15, 25, 35, 45) लें

⇒ Y-अक्ष पर आवृत्ति (5, 8, 12, 7, 3) लें

⇒ सभी बिंदुओं को सीधी रेखा से जोड़ें

✍️  शुरुआत और अंत में (0,0) जैसे बिंदु जोड़कर ग्राफ को पूरा किया जाता है।

व्याख्या (Interpretation):

⇒ सबसे अधिक आवृत्ति 25 (20–30 वर्ग) पर है।

⇒ इससे पता चलता है कि अधिकतर छात्रों के अंक 20–30 के बीच हैं।

✍️  विभिन्न डेटा सेट की तुलना करने में

✍️  वितरण की प्रवृत्ति समझने में

✍️  शोध और विश्लेषण में

हिस्टोग्राम और आवृत्ति बहुभुज में अंतर (Difference):

आधार हिस्टोग्राम आवृत्ति बहुभुज
रूप आयताकार (Bars) रेखीय (Line)
डेटा सतत श्रेणी सतत व खंडित दोनों
उपयोग वितरण दिखाने में तुलना करने में
निर्माण आयत बनाकर बिंदु जोड़कर

महत्व (Importance):

✍️  ये तकनीकें डेटा को सरल और दृश्य रूप में प्रस्तुत करती हैं।

✍️  जटिल आंकड़ों को समझना आसान हो जाता है।

✍️  शोध, शिक्षा और नीति निर्माण में सहायक होती हैं।

3. Mode / बहुलक

Mode 

बहुलक

परिचय (Introduction):

     सांख्यिकी (Statistics) में केन्द्रीय प्रवृत्ति (Measures of Central Tendency) के तीन प्रमुख माप होते हैं- माध्य (Mean), माध्यिका (Median) और बहुलक (Mode)। इनमें से बहुलक वह मान होता है जो किसी आंकड़ों के समूह में सबसे अधिक बार प्रकट होता है।

    दूसरे शब्दों में, जिस मान की आवृत्ति (Frequency) सबसे अधिक होती है, वही बहुलक कहलाता है।

   बहुलक को सामान्य भाषा में सबसे सामान्य या प्रचलित मान भी कहा जाता है। उदाहरण के लिए, यदि किसी कक्षा में छात्रों के जूतों के आकार (Shoe Size) में 7 सबसे अधिक बार आता है, तो 7 उस समूह का बहुलक होगा।

परिभाषा (Definition):

     बहुलक वह मान है जिसकी आवृत्ति किसी श्रेणी में सबसे अधिक होती है।

सांख्यिकीविदों के अनुसार:

“The mode is the value which occurs most frequently in a series.”

     अर्थात जिस मान की पुनरावृत्ति सबसे अधिक होती है, वही बहुलक कहलाता है।

बहुलक की विशेषताएँ (Characteristics of Mode):-

✍️ बहुलक वह मान है जो सबसे अधिक बार आता है।

✍️ यह सबसे सामान्य या प्रचलित मान को दर्शाता है।

✍️ बहुलक को ग्राफ द्वारा भी निकाला जा सकता है।

✍️ यह चरम मानों (Extreme Values) से प्रभावित नहीं होता।

✍️ कभी-कभी किसी श्रेणी में एक से अधिक बहुलक भी हो सकते हैं।

1. व्यक्तिगत श्रेणी (Individual Series) में बहुलक:-

   व्यक्तिगत श्रेणी में प्रत्येक मान अलग-अलग दिया होता है। इसमें बहुलक वह मान होता है जो सबसे अधिक बार दोहराया गया हो।

उदाहरण:

आंकड़े: 2, 4, 6, 6, 7, 8, 6, 9

   यहाँ 6 तीन बार आया है, जो सबसे अधिक है।

इसलिए बहुलक = 6

2. खंडित श्रेणी (Discrete Series) में बहुलक:-

   खंडित श्रेणी में मान (X) और उनकी आवृत्ति (f) दी होती है। जिस मान की आवृत्ति सबसे अधिक होती है वही बहुलक होता है।

उदाहरण:

X f
10 2
20 5
30 7
40 4

यहाँ 30 की आवृत्ति सबसे अधिक (7) है।

इसलिए बहुलक = 30

3. सतत श्रेणी (Continuous Series) में बहुलक:-

     सतत श्रेणी में बहुलक निकालने के लिए एक विशेष सूत्र का प्रयोग किया जाता है।

सूत्र (Formula)-

जहाँ

L = बहुलक वर्ग की निचली सीमा / Lower Limit of Modal Class

f₁ = बहुलक वर्ग की आवृत्ति / Frequency of Modal Class

f₀ = बहुलक वर्ग से पहले की आवृत्ति / Frequency of Class preceding the Modal Class

f₂ = बहुलक वर्ग के बाद की आवृत्ति / Frequency of Class succeeding the Modal Class

h = वर्ग अंतराल (Class Interval) / Class Interval / Class Width

नोट: बहुलक वर्ग (Modal Class)- जिस वर्ग की आवृत्ति सबसे अधिक होती है, उसे बहुलक वर्ग (Modal Class) कहा जाता है।

उदाहरण-

वर्ग आवृत्ति
0–10 5
10–20 8
20–30 12
30–40 7
यहाँ 20–30 की आवृत्ति सबसे अधिक (12) है। इसलिए 20–30 बहुलक वर्ग होगा।

L = 20 (बहुलक वर्ग की निचली सीमा)

f₁ = 12 (बहुलक वर्ग की आवृत्ति)

f₀ = 8 (पहले वाले वर्ग की आवृत्ति)

f₂ = 7 (अगले वर्ग की आवृत्ति)

h = 10 (वर्ग अंतराल)

Now,

Mode

Mode = 20+(12-8)/(2 X 12-8-7) X 10

           = 20+4/(24-15) X 10

           = 20+4/9 X10

           = 20+4.44

           = 24.44

नोट: माध्य, माध्यिका और बहुलक का संबंध:

    सांख्यिकी में एक महत्वपूर्ण संबंध होता है:

Mode = 3Median−2Mean

यह सूत्र तब उपयोगी होता है जब किसी श्रेणी में माध्य और माध्यिका ज्ञात हों।

बहुलक के गुण (Merits of Mode):-

(i) सरल और आसानी से समझने योग्य:-

      बहुलक निकालना बहुत आसान है।

(ii) चरम मानों से प्रभावित नहीं होता:-

     बहुत बड़े या छोटे मान इसका प्रभाव कम करते हैं।

(iii) व्यावहारिक महत्व:-

     व्यापार और उद्योग में इसका व्यापक उपयोग होता है।

(iv) ग्राफ द्वारा ज्ञात:-

     हिस्टोग्राम की सहायता से बहुलक निकाला जा सकता है।

(v) गुणात्मक आंकड़ों के लिए उपयोगी:-

    जहाँ संख्यात्मक औसत संभव नहीं होता, वहाँ बहुलक उपयोगी होता है।

बहुलक की सीमाएँ (Limitations of Mode):-

(i) सभी मानों पर आधारित नहीं होता:-

     यह केवल सबसे अधिक आवृत्ति वाले मान पर आधारित होता है।

(ii) कभी-कभी बहुलक स्पष्ट नहीं होता:-

    कई बार दो या अधिक बहुलक हो सकते हैं।

(iii) गणितीय विश्लेषण में कम उपयोगी:-

    आगे की गणनाओं में इसका प्रयोग सीमित होता है।

(iv) छोटे डेटा में विश्वसनीय नहीं:-

    बहुत छोटे आंकड़ों में बहुलक सही परिणाम नहीं देता।

निष्कर्ष (Conclusion):

    इस प्रकार बहुलक सांख्यिकी में केन्द्रीय प्रवृत्ति का एक महत्वपूर्ण माप है जो किसी आंकड़ों के समूह में सबसे अधिक बार आने वाले मान को दर्शाता है। यह विशेष रूप से तब उपयोगी होता है जब हमें किसी समूह का सबसे सामान्य या प्रचलित मान जानना हो। हालांकि इसकी कुछ सीमाएँ भी हैं, फिर भी व्यापार, अर्थशास्त्र, शिक्षा और सामाजिक विज्ञानों में इसका व्यापक उपयोग किया जाता है।

     इस प्रकार बहुलक न केवल सरल और व्यावहारिक है, बल्कि यह किसी भी डेटा के सामान्य व्यवहार को समझने में महत्वपूर्ण भूमिका निभाता है।

2. Median / माध्यिका

Median 

माध्यिका

माध्यिका (Median):

      सांख्यिकी में केन्द्रीय प्रवृत्ति का एक महत्वपूर्ण माप है। यह वह मान होता है जो किसी व्यवस्थित (आरोही या अवरोही क्रम में रखे गए) आंकड़ों के समूह को दो बराबर भागों में विभाजित करता है। अर्थात् आधे मान माध्यिका से छोटे होते हैं और आधे मान उससे बड़े होते हैं।

      माध्यिका का उपयोग विशेष रूप से तब किया जाता है जब आंकड़ों में अत्यधिक बड़े या छोटे मान (extreme values) मौजूद हों, क्योंकि ऐसे मान औसत (Mean) को प्रभावित कर सकते हैं, लेकिन माध्यिका पर उनका प्रभाव कम पड़ता है। इसलिए इसे अधिक स्थिर और विश्वसनीय माप माना जाता है।

      यदि आंकड़ों की संख्या विषम (odd) हो, तो माध्यिका वह मध्य का मान होता है जो सभी मानों को क्रम में रखने पर बीच में आता है। उदाहरण के लिए: 3, 5, 7, 9, 11 में माध्यिका 7 है।

     यदि आंकड़ों की संख्या सम (even) हो, तो बीच के दो मानों का औसत माध्यिका कहलाता है। जैसे: 2, 4, 6, 8 में माध्यिका (4 + 6) / 2 = 5 होगी।

     भूगोल, अर्थशास्त्र, समाजशास्त्र तथा जनसंख्या अध्ययन में माध्यिका का व्यापक उपयोग किया जाता है। उदाहरण के लिए आय वितरण, जनसंख्या घनत्व या भूमि स्वामित्व के अध्ययन में माध्यिका वास्तविक स्थिति को बेहतर ढंग से दर्शाती है। इस प्रकार, माध्यिका आंकड़ों के विश्लेषण में एक महत्वपूर्ण और उपयोगी सांख्यिकीय माप है।

1. व्यक्तिगत श्रेणी (Individual Series) में माध्यिका की गणना:

     व्यक्तिगत श्रेणी में प्रत्येक आंकड़ा अलग-अलग दिया होता है और उनकी कोई आवृत्ति (frequency) नहीं होती। ऐसे आंकड़ों में माध्यिका निकालने के लिए सबसे पहले सभी मानों को आरोही (छोटे से बड़े) या अवरोही (बड़े से छोटे) क्रम में व्यवस्थित किया जाता है। इसके बाद कुल पदों की संख्या के आधार पर माध्यिका ज्ञात की जाती है।

✍️ जब पदों की संख्या विषम (Odd) हो-

     यदि कुल पदों की संख्या n विषम है, तो माध्यिका का स्थान (n+1)/2 होता है। अर्थात जो मान इस स्थान पर होगा वही माध्यिका कहलाएगा।

उदाहरण:

आंकड़े: 5, 9, 3, 7, 11

क्रम में रखने पर: 3, 5, 7, 9, 11

यहाँ n = 5

माध्यिका का स्थान = (5+1)/2 = 3

तीसरे स्थान का मान 7 है, इसलिए माध्यिका = 7।

✍️ जब पदों की संख्या सम (Even) हो-

    यदि कुल पदों की संख्या n सम है, तो माध्यिका बीच के दो पदों के औसत से निकाली जाती है।

सूत्र:

उदाहरण:

आंकड़े: 4, 8, 6, 10

क्रम में: 4, 6, 8, 10

यहाँ n=4

माध्यिका = (6 + 8) / 2 = 7।

     इस प्रकार व्यक्तिगत श्रेणी में माध्यिका निकालने की प्रक्रिया सरल होती है और यह आंकड़ों को दो बराबर भागों में विभाजित करने वाला मध्य मान दर्शाती है।

2. खंडित श्रेणी (Discrete Series) में माध्यिका की गणना:

    खंडित श्रेणी में प्रत्येक मान (Value) के साथ उसकी आवृत्ति (Frequency) दी होती है। माध्यिका ज्ञात करने के लिए निम्नलिखित चरण अपनाए जाते हैं।

✍️ सबसे पहले कुल आवृत्ति (N) ज्ञात करें

      सभी आवृत्तियों को जोड़कर कुल आवृत्ति अर्थात् N निकालते हैं।

✍️ उसके बाद संचयी आवृत्ति (Cumulative Frequency) बनाएं

       आवृत्तियों को क्रमशः जोड़कर संचयी आवृत्ति तैयार की जाती है।

✍️ उसके बाद N/2 वाँ पद का मान निकालें

      कुल आवृत्ति को 2 से भाग देकर N/2 का मान प्राप्त करते हैं।

✍️ फिर माध्यिका का मान निर्धारित करें

      संचयी आवृत्ति में वह पहला मान खोजते हैं जो N/2 के बराबर या उससे बड़ा हो। उसी के सामने जो मान (Value) होगा वही माध्यिका कहलाता है।

उदाहरण-

मान (X) आवृत्ति (f) संचयी आवृत्ति (cf)
10 3 3
20 5 8
30 7 15
40 4 19
50 1 20

यहाँ,

N = 20

N/2 = 10

    संचयी आवृत्ति में 10 से बड़ा या बराबर पहला मान 15 है, जो 30 के सामने है।

अतः माध्यिका = 30

सूत्र-

Median = वह मान जिसकी संचयी आवृत्ति N/2 के बराबर या उससे अधिक हो।

    इस प्रकार खंडित श्रेणी में माध्यिका निकालने के लिए संचयी आवृत्ति का प्रयोग किया जाता है और यह आँकड़ों को दो बराबर भागों में विभाजित करती है।

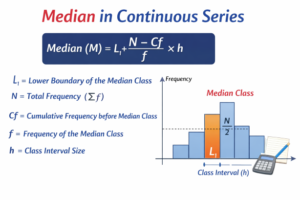
3. सतत श्रेणी (Continuous Series) में माध्यिका की गणना:

    सतत श्रेणी में आंकड़े वर्ग-अंतराल (Class Interval) के रूप में दिए होते हैं, जैसे 0–10, 10–20, 20–30 आदि। ऐसी स्थिति में माध्यिका निकालने के लिए एक विशेष सूत्र का उपयोग किया जाता है।

चरण (Steps):-

✍️ संचयी आवृत्ति (Cumulative Frequency) तैयार करें।

     दिए गए वर्गों की आवृत्तियों को क्रम से जोड़कर संचयी आवृत्ति बनाते हैं।

✍️ कुल आवृत्ति (N) ज्ञात करें।

    सभी आवृत्तियों को जोड़कर N निकालते हैं।

✍️ N/2 का मान निकालें।

    कुल आवृत्ति को 2 से भाग देते हैं।

✍️ माध्यिका वर्ग (Median Class) पहचानें।

     संचयी आवृत्ति में वह वर्ग खोजते हैं जिसकी संचयी आवृत्ति N/2 के बराबर या उससे अधिक हो। वही माध्यिका वर्ग कहलाता है।

सूत्र-

हाँ-

M = माध्यिका मूल्य

l = माध्यिका वर्गान्तर की निचली सीमा

i = माध्यिका वर्गान्तर का विस्तार

f = माध्यिका वर्ग की आवृत्ति

c = माध्यिका वर्गान्तर से पहले वर्गान्तर की संचयी आवृति

अथवा

जहाँ-

L = माध्यिका वर्ग की निचली सीमा

N = कुल आवृत्ति

Cf = माध्यिका वर्ग से पहले की संचयी आवृत्ति

f = माध्यिका वर्ग की आवृत्ति

h = वर्ग अंतराल (class width)

उदाहरण-

1. निम्नांकित सारणी में 100 परीक्षार्थियों के प्राप्तांक दिए गये है। माध्यिका की गणना कीजिये:

प्राप्तांक परीक्षार्थियों की संख्या
0-10 06
10-20 30
20-30 40
30-40 14
40-50 10

हल:

प्राप्तांक

(वर्गान्तर)

परीक्षार्थियों की संख्या

(आवृति)

 संचयी आवृति
0-10 06 06
10-20 30 36
20-30 40 76
30-40 14 90
40-50 10 100

m = N/2 वाँ वार्गांतर

      = 100/2

      = 50 वाँ वार्गांतर

माध्यिका वार्गांतर = 20-30

Now,

      = 20+10/40 (50-36)

      = 20+(10×40)/40

      = 20+140/40

      = (800+400)/40

      = 940/40

  माध्यिका प्राप्तांक = 23.5

माध्यिका के गुण (Merits of Median)

(i) सरल और समझने में आसान:

       माध्यिका निकालने की विधि बहुत सरल होती है और इसे आसानी से समझा जा सकता है।

(ii) चरम मानों से प्रभावित नहीं होती:

     बहुत अधिक या बहुत कम मान (Extreme Values) माध्यिका को अधिक प्रभावित नहीं करते।

(iii) क्रमबद्ध आंकड़ों के लिए उपयुक्त:

    जब आंकड़े क्रम (order) में हों तो माध्यिका आसानी से निकाली जा सकती है।

(iv) खुले वर्ग अंतराल (Open-end classes) में भी उपयोगी:

    सतत श्रेणी में जहाँ वर्ग अंतराल खुले होते हैं, वहाँ भी माध्यिका निकाली जा सकती है।

(v) ग्राफ द्वारा भी ज्ञात: ओजाइव (Ogive Curve) की सहायता से भी माध्यिका का मान निकाला जा सकता है।

माध्यिका की सीमाएँ (Limitations of Median)

(i) सभी मानों पर आधारित नहीं होती:

     माध्यिका केवल मध्य मान पर आधारित होती है, इसलिए सभी आंकड़ों का पूरा उपयोग नहीं होता।

(ii) गणितीय विश्लेषण में कम उपयोगी:

    माध्यिका पर आगे के गणितीय विश्लेषण करना कठिन होता है।

(iii) अधिक सटीक नहीं मानी जाती:

    कई बार यह औसत (Mean) जितनी सटीक जानकारी नहीं देती।

(iv) क्रमबद्ध करना आवश्यक:

    माध्यिका निकालने से पहले आंकड़ों को क्रम में रखना जरूरी होता है।

निष्कर्ष (Conclusion):

    माध्यिका सांख्यिकी में केन्द्रीय प्रवृत्ति का एक महत्वपूर्ण माप है। यह विशेष रूप से तब उपयोगी होती है जब आंकड़ों में बहुत अधिक या बहुत कम मान मौजूद हों। हालांकि इसके कुछ सीमित पक्ष भी हैं, फिर भी आय वितरण, जनसंख्या अध्ययन और सामाजिक विज्ञानों में वास्तविक स्थिति को समझने के लिए माध्यिका का व्यापक उपयोग किया जाता है।

1. Field Techniques: Merits, Demerits and Selection / फील्ड तकनीकों के लाभ, सीमाएँ तथा उनका चयन

Field Techniques: Merits, Demerits and Selection 

फील्ड तकनीकों के लाभ, सीमाएँ तथा उनका चयन

Field Techniques

परिचय (Introduction)

      भूगोल तथा अन्य सामाजिक विज्ञानों में फील्ड वर्क (Field Work) शोध की एक महत्वपूर्ण प्रक्रिया है। फील्ड वर्क के दौरान शोधकर्ता वास्तविक क्षेत्र में जाकर प्रत्यक्ष रूप से डेटा एकत्र करता है। इस प्रक्रिया में विभिन्न फील्ड तकनीकों (Field Techniques) का उपयोग किया जाता है, जिनकी सहायता से शोधकर्ता किसी क्षेत्र की भौतिक, सामाजिक, आर्थिक और पर्यावरणीय विशेषताओं का अध्ययन करता है।

     फील्ड तकनीकें डेटा संग्रहण, विश्लेषण और निष्कर्ष निकालने में महत्वपूर्ण भूमिका निभाती हैं। इसलिए किसी भी शोध में सही तकनीक का चयन करना आवश्यक होता है।

फील्ड तकनीकों का अर्थ (Meaning of Field Techniques)

    फील्ड तकनीकें वे विधियाँ या तरीके हैं जिनकी सहायता से शोधकर्ता क्षेत्र में जाकर प्रत्यक्ष रूप से जानकारी एकत्र करता है।

    इन तकनीकों में मुख्य रूप से शामिल हैं-

(i) अवलोकन (Observation)

(ii) साक्षात्कार (Interview)

(iii) प्रश्नावली (Questionnaire)

(iv) अनुसूची (Schedule)

(v) सर्वेक्षण (Survey)

(vi) मापन और मानचित्रण (Measurement & Mapping)

     इनका उद्देश्य क्षेत्र से प्राथमिक आँकड़े (Primary Data) प्राप्त करना होता है।

फील्ड तकनीकों के लाभ (Merits of Field Techniques):

     फील्ड तकनीकें शोध कार्य में अत्यंत महत्वपूर्ण भूमिका निभाती हैं, क्योंकि इनके माध्यम से शोधकर्ता सीधे अध्ययन क्षेत्र में जाकर जानकारी एकत्र करता है। इसके प्रमुख लाभ निम्नलिखित हैं-

(i) प्रत्यक्ष और वास्तविक जानकारी:-

       फील्ड तकनीकों के माध्यम से शोधकर्ता स्वयं क्षेत्र में जाकर डेटा एकत्र करता है, जिससे प्राप्त जानकारी अधिक सटीक और वास्तविक होती है।

(ii) प्राथमिक आँकड़ों की प्राप्ति:-

      इन तकनीकों से शोधकर्ता को सीधे क्षेत्र से प्राथमिक डेटा (Primary Data) प्राप्त होता है, जो शोध के लिए अधिक विश्वसनीय माना जाता है।

(iii) क्षेत्र की वास्तविक परिस्थितियों की समझ:-

      फील्ड वर्क के दौरान शोधकर्ता क्षेत्र की भौगोलिक, सामाजिक और आर्थिक परिस्थितियों को प्रत्यक्ष रूप से समझ सकता है।

(iv) समस्या का गहन अध्ययन संभव:-

      फील्ड तकनीकें किसी भी समस्या या विषय का विस्तृत और गहराई से अध्ययन करने में सहायक होती हैं।

(v) स्थानीय लोगों से संपर्क:-

    फील्ड कार्य के दौरान शोधकर्ता का स्थानीय लोगों से संपर्क होता है, जिससे स्थानीय समस्याओं और स्थितियों की सही जानकारी मिलती है।

(vi) व्यवहारिक ज्ञान में वृद्धि:-

     फील्ड वर्क के माध्यम से शोधकर्ता को व्यावहारिक अनुभव प्राप्त होता है, जिससे उसके ज्ञान और समझ में वृद्धि होती है।

(vii) मानचित्रण और विश्लेषण में सहायता:-

     फील्ड तकनीकों से प्राप्त आँकड़ों के आधार पर मानचित्र, ग्राफ और चार्ट तैयार करना आसान हो जाता है।

(viii) शोध की विश्वसनीयता:-

     प्रत्यक्ष रूप से एकत्रित आँकड़ों के कारण शोध अधिक वैज्ञानिक और विश्वसनीय बन जाता है।

फील्ड तकनीकों की सीमाएँ (Demerits of Field Techniques):

     फील्ड तकनीकें शोध कार्य में उपयोगी होती हैं, लेकिन इनके कुछ महत्वपूर्ण सीमाएँ भी होती हैं। ये सीमाएँ निम्नलिखित हैं-

(i) अधिक समय की आवश्यकता:-

      फील्ड वर्क करने में काफी समय लगता है क्योंकि शोधकर्ता को क्षेत्र में जाकर डेटा एकत्र करना पड़ता है।

(ii) खर्च अधिक:-

   फील्ड कार्य के दौरान यात्रा, आवास, उपकरण और अन्य व्यवस्थाओं पर अधिक खर्च करना पड़ता है।

(iii) कठिन भौगोलिक परिस्थितियाँ:-

     कई बार अध्ययन क्षेत्र दूरस्थ या दुर्गम होता है, जिससे डेटा संग्रहण में कठिनाई आती है।

(iv) मौसम का प्रभाव:-

     बारिश, अत्यधिक गर्मी या ठंड जैसी प्राकृतिक परिस्थितियाँ फील्ड कार्य को प्रभावित कर सकती हैं।

(v) उत्तरदाताओं का सहयोग न मिलना:-

    कभी-कभी लोग सही जानकारी देने से हिचकिचाते हैं या सहयोग नहीं करते, जिससे डेटा अधूरा रह सकता है।

(vi) मानवीय त्रुटियों की संभावना:-

   अवलोकन या साक्षात्कार के दौरान शोधकर्ता से गलती होने की संभावना रहती है।

(vii) सीमित क्षेत्र में अध्ययन:-

    फील्ड वर्क आमतौर पर सीमित क्षेत्र तक ही किया जा सकता है, इसलिए बड़े क्षेत्र का अध्ययन कठिन हो जाता है।

(viii) डेटा विश्लेषण में कठिनाई:-

    फील्ड से प्राप्त अधिक मात्रा में आँकड़ों को व्यवस्थित करना और उनका विश्लेषण करना कभी-कभी कठिन हो जाता है।

फील्ड तकनीकों का चयन (Selection of Field Techniques):

    फील्ड तकनीकों का चयन किसी भी शोध कार्य की सफलता के लिए अत्यंत महत्वपूर्ण होता है। उचित तकनीक के चयन से डेटा संग्रहण अधिक प्रभावी और विश्वसनीय बनता है। फील्ड तकनीकों के चयन में निम्नलिखित बातों का ध्यान रखा जाता है-

(i) शोध के उद्देश्य के आधार पर:-

    फील्ड तकनीक का चयन शोध के उद्देश्य के अनुसार किया जाता है। यदि अध्ययन सामाजिक विषयों से संबंधित है तो साक्षात्कार या प्रश्नावली उपयुक्त होती है।

(ii) अध्ययन क्षेत्र की प्रकृति:-

      अध्ययन क्षेत्र की भौगोलिक और सामाजिक परिस्थितियाँ भी तकनीक के चयन को प्रभावित करती हैं। कठिन या दूरस्थ क्षेत्रों में सरल तकनीकों का उपयोग किया जाता है।

(iii) समय की उपलब्धता:-

     यदि शोध के लिए समय सीमित है, तो ऐसी तकनीकों का चयन किया जाता है जिनसे कम समय में अधिक डेटा प्राप्त किया जा सके।

(iv) आर्थिक संसाधन:-

     फील्ड वर्क में खर्च भी एक महत्वपूर्ण कारक है। इसलिए शोधकर्ता को उपलब्ध आर्थिक संसाधनों के अनुसार तकनीक का चयन करना चाहिए।

(v) डेटा की प्रकृति:-

    यदि शोध में गुणात्मक डेटा चाहिए तो अवलोकन और साक्षात्कार उपयोगी होते हैं, जबकि मात्रात्मक डेटा के लिए सर्वेक्षण और मापन तकनीकें अधिक उपयुक्त होती हैं।

(vi) शोधकर्ता का अनुभव और कौशल:-

     तकनीक का चयन शोधकर्ता के अनुभव, ज्ञान और प्रशिक्षण पर भी निर्भर करता है।

(vii) उत्तरदाताओं की उपलब्धता:-

     यदि उत्तरदाता आसानी से उपलब्ध हों, तो साक्षात्कार और प्रश्नावली जैसी तकनीकें अधिक प्रभावी होती हैं।

निष्कर्ष (Conclusion):

     इस प्रकार फील्ड तकनीकें किसी भी भौगोलिक और सामाजिक शोध का महत्वपूर्ण हिस्सा होती हैं। इनके माध्यम से शोधकर्ता क्षेत्र में जाकर वास्तविक परिस्थितियों का अध्ययन करता है और प्राथमिक आँकड़े प्राप्त करता है। यद्यपि फील्ड तकनीकों में समय, धन और श्रम अधिक लगता है, फिर भी इनके द्वारा प्राप्त जानकारी अधिक सटीक और विश्वसनीय होती है। इसलिए शोध के उद्देश्य, संसाधनों और अध्ययन क्षेत्र की प्रकृति को ध्यान में रखते हुए उपयुक्त फील्ड तकनीक का चयन करना आवश्यक होता है।

     इस प्रकार, सही फील्ड तकनीकों के उपयोग से शोध अधिक प्रभावी, वैज्ञानिक और विश्वसनीय बनता है।

4. Observation Method / अवलोकन विधि

Observation Method

अवलोकन विधि

    Observation Method

    Observation Method / अवलोकन विधि प्राथमिक आँकड़े (Primary Data) एकत्र करने की एक महत्वपूर्ण विधि है। इसमें शोधकर्ता किसी व्यक्ति, घटना, वस्तु या गतिविधि को सीधे देखकर, समझकर और नोट करके जानकारी एकत्र करता है। इसमें उत्तरदाता से प्रश्न पूछना जरूरी नहीं होता, बल्कि प्रत्यक्ष निरीक्षण के आधार पर तथ्य इकट्ठे किए जाते हैं।

    सरल शब्दों में जब शोधकर्ता किसी घटना या व्यवहार को प्रत्यक्ष रूप से देखकर जानकारी जुटाता है, तो उसे अवलोकन विधि कहते हैं।

   अर्थात् अवलोकन विधि वह विधि है जिसमें शोधकर्ता किसी घटना या व्यवहार को सीधे देखकर जानकारी एकत्र करता है।

उदाहरण

✍️ शिक्षक द्वारा कक्षा में छात्रों के व्यवहार का निरीक्षण करना।

✍️ शोधकर्ता द्वारा बाजार में लोगों की खरीदारी की आदतों को देखना।

✍️ कृषि वैज्ञानिक द्वारा खेत में फसल की वृद्धि का निरीक्षण करना।

✍️ यातायात पुलिस द्वारा सड़क पर वाहनों की संख्या और गति का अवलोकन करना।

अवलोकन विधि के प्रकार

       अवलोकन विधि (Observation Method) के मुख्य प्रकार इस प्रकार हैं-

1.  सहभागी अवलोकन (Participant Observation) 

2. असहभागी अवलोकन (Non-Participant Observation) 

3. संरचित अवलोकन (Structured Observation) 

4. असंरचित अवलोकन (Unstructured Observation)

1. सहभागी अवलोकन (Participant Observation) :-

      सहभागी अवलोकन वह विधि है जिसमें शोधकर्ता अध्ययन किए जा रहे समूह या समुदाय का स्वयं हिस्सा बनकर उनकी गतिविधियों और व्यवहार का निरीक्षण करता है। इस विधि में शोधकर्ता लोगों के साथ रहकर उनके दैनिक जीवन, परंपराओं और व्यवहार को समझता है।

     इससे जानकारी अधिक वास्तविक और गहन मिलती है। उदाहरण के लिए, कोई शोधकर्ता गाँव में रहकर वहाँ के लोगों की जीवन-शैली और सामाजिक गतिविधियों का अध्ययन करता है। इस प्रकार सहभागी अवलोकन से सामाजिक व्यवहार को अच्छी तरह समझा जा सकता है।

2. असहभागी अवलोकन (Non-Participant Observation) :-     

       असहभागी अवलोकन वह विधि है जिसमें शोधकर्ता किसी समूह, घटना या गतिविधि का अध्ययन उसका हिस्सा बने बिना करता है। वह केवल दूर से निरीक्षण करता है और जो भी गतिविधियाँ होती हैं उन्हें ध्यानपूर्वक देखकर नोट करता है।

     इस विधि में शोधकर्ता का हस्तक्षेप बहुत कम होता है, इसलिए लोगों का व्यवहार स्वाभाविक रहता है। उदाहरण के लिए, एक शिक्षक कक्षा में बैठकर छात्रों के व्यवहार को बिना उनके कार्यों में भाग लिए केवल देखता और लिखता है।

3. संरचित अवलोकन (Structured Observation) :-   

     संरचित अवलोकन वह विधि है जिसमें शोधकर्ता किसी घटना या व्यवहार का अध्ययन पहले से तय योजना, नियम या चेकलिस्ट के आधार पर करता है। इस विधि में यह पहले ही निर्धारित कर लिया जाता है कि कौन-कौन सी बातों का अवलोकन करना है और किस प्रकार जानकारी दर्ज करनी है। इससे प्राप्त आँकड़े अधिक व्यवस्थित और तुलनात्मक होते हैं।

उदाहरण के लिए, यदि कोई शोधकर्ता कक्षा में छात्रों के व्यवहार का अध्ययन करना चाहता है, तो वह पहले से एक सूची बना लेता है जैसे—कितने छात्र ध्यान से पढ़ रहे हैं, कितने नोट्स लिख रहे हैं और कितने बातचीत कर रहे हैं। इस प्रकार निश्चित योजना के अनुसार किया गया निरीक्षण संरचित अवलोकन कहलाता है।

4. असंरचित अवलोकन (Unstructured Observation) :-

    असंरचित अवलोकन वह विधि है जिसमें शोधकर्ता बिना किसी पूर्व निर्धारित योजना, सूची या प्रश्नों के किसी घटना, व्यक्ति या गतिविधि का निरीक्षण करता है। इसमें शोधकर्ता परिस्थिति के अनुसार जो भी महत्वपूर्ण जानकारी दिखाई देती है, उसे स्वतंत्र रूप से नोट करता है।

     इस विधि में अवलोकन अधिक लचीला और खुला होता है, जिससे शोधकर्ता को विषय को गहराई से समझने का अवसर मिलता है। उदाहरण के लिए, यदि कोई शोधकर्ता किसी गाँव के सामाजिक जीवन का अध्ययन करना चाहता है, तो वह गाँव में रहकर लोगों की दैनिक गतिविधियों, व्यवहार और परंपराओं का निरीक्षण करता है।

अवलोकन विधि के लाभ:

   इसके कई महत्वपूर्ण लाभ होते हैं।

(i) प्रत्यक्ष जानकारी प्राप्त – इस विधि में शोधकर्ता स्वयं देखकर तथ्य एकत्र करता है, इसलिए जानकारी अधिक सटीक और वास्तविक होती है।

(ii) विश्वसनीयता अधिक – अवलोकन द्वारा प्राप्त आँकड़े सामान्यतः अधिक भरोसेमंद होते हैं क्योंकि वे प्रत्यक्ष अनुभव पर आधारित होते हैं।

(iii) प्राकृतिक व्यवहार का अध्ययन संभव – इस विधि से लोगों के व्यवहार को उनकी स्वाभाविक स्थिति में देखा जा सकता है।

(iv) अनपढ़ लोगों के लिए भी उपयोगी – इसमें उत्तरदाता को पढ़ना या लिखना नहीं पड़ता, इसलिए यह सभी प्रकार के लोगों पर लागू होती है।

(v) वास्तविक परिस्थितियों का ज्ञान – अवलोकन से वास्तविक स्थिति और वातावरण को समझना आसान होता है।

(vi) तुरंत जानकारी – घटनाओं का उसी समय निरीक्षण करके तुरंत डेटा प्राप्त किया जा सकता है।

(vii) व्यवहार और गतिविधियों का सही अध्ययन – लोगों की क्रियाओं और गतिविधियों का सटीक विश्लेषण किया जा सकता है।

(viii) अन्य विधियों की पुष्टि में सहायक – यह विधि प्रश्नावली और साक्षात्कार से प्राप्त जानकारी की सत्यता की जाँच करने में भी सहायक होती है।

      इस प्रकार अवलोकन विधि शोध कार्य में बहुत उपयोगी और प्रभावी मानी जाती है।

अवलोकन विधि की सीमाएँ:

✍️ इसमें अधिक समय और मेहनत लगती है।

✍️ हर प्रकार की जानकारी अवलोकन से प्राप्त नहीं हो सकती।

✍️ कभी-कभी शोधकर्ता की व्यक्तिगत सोच का प्रभाव पड़ सकता है।

निष्कर्ष (Conclusion)

    इस प्रकार अवलोकन विधि प्राथमिक आँकड़ों के संकलन की एक महत्वपूर्ण और उपयोगी विधि है। इसमें शोधकर्ता किसी घटना, व्यक्ति या गतिविधि का प्रत्यक्ष निरीक्षण करके जानकारी प्राप्त करता है। इस विधि से प्राप्त आँकड़े अधिक वास्तविक और विश्वसनीय होते हैं, क्योंकि वे सीधे अनुभव पर आधारित होते हैं।

      हालांकि इसमें समय और मेहनत अधिक लगती है, फिर भी सामाजिक तथा वैज्ञानिक शोध में यह विधि बहुत प्रभावी मानी जाती है और सही निष्कर्ष निकालने में सहायक होती है।

1. Measurement of Central Tendency (केन्द्रीय प्रवृत्ति  की माप) : Mean (माध्य)

Measurement of Central Tendency

(केन्द्रीय प्रवृत्ति  की माप) : Mean (माध्य)


परिचय:

   केन्द्रीय प्रवृत्ति (Central Tendency) सांख्यिकी का एक महत्वपूर्ण सिद्धांत है, जिसके माध्यम से किसी भी आँकड़ा-समूह (data set) का प्रतिनिधि या केंद्रीय मान ज्ञात किया जाता है। सरल शब्दों में, यह बताता है कि दिए गए आंकड़ों का “मध्य” या “औसत” मान क्या है, जिसके आसपास अधिकांश मान केंद्रित होते हैं।

जब किसी क्षेत्र, जनसंख्या, तापमान, वर्षा या उत्पादन आदि से संबंधित बहुत सारे आँकड़े एकत्र किए जाते हैं, तो उन्हें समझना कठिन हो सकता है। ऐसे में केन्द्रीय प्रवृत्ति का माप उन सभी मानों को एक संक्षिप्त और अर्थपूर्ण रूप में प्रस्तुत करता है।

केन्द्रीय प्रवृत्ति के तीन मुख्य माप हैं-

1. माध्य (Mean) सभी मानों का औसत।

2. माध्यिका (Median) मध्य का मान।

3. बहुलक (Mode) सर्वाधिक बार आने वाला मान।

     भूगोल में केन्द्रीय प्रवृत्ति का उपयोग औसत तापमान, औसत वर्षा, जनसंख्या घनत्व, साक्षरता दर आदि के अध्ययन में किया जाता है। यह क्षेत्रीय तुलना, विकास स्तर के विश्लेषण तथा प्रवृत्तियों को समझने में अत्यंत सहायक है।

     इस प्रकार, केन्द्रीय प्रवृत्ति जटिल आँकड़ों को सरल और सारगर्भित रूप में प्रस्तुत करने का एक प्रभावी साधन है।

माध्य (Mean) :

      माध्य वह मान है जो किसी चर राशि के सभी मानों के कुल योग को उनकी संख्या से विभाजित करने पर प्राप्त होता है। इसे सामान्य भाषा में औसत (Average) भी कहा जाता है। इसे अंकगणितीय माध्य या समान्तर माध्य भी कहते हैं।

Croxton & Cowden के अनुसार–  “औसत समंकों के विस्तार के अंतर्गत स्थित एक ऐसा मान है जिसका प्रयोग श्रेणी के सभी मूल्यों का प्रतिनिधित्व करने के लिए किया जाता है।”

       किसी समंक श्रेणी के विस्तार के मध्य में स्थित होने के कारण औसत को केन्द्रीय प्रवृत्ति की माप भी कहा जाता है। औसत या माध्य का सांख्यिकी में विशेष महत्व है। डा. एल. एल. बाउले ने सांख्यिकी को ‘माध्यों’ का विज्ञान’ कहकर संबोधित किया है।

समान्तर माध्य या औसत की गणना :

       समान्तर माध्य की गणना करने हेतु निम्नलिखित दो विधियाँ होती हैं-

(1) प्रत्यक्ष विधि: जब किसी समंक श्रेणी में पद-मूल्यों की संख्या कम हो तथा उनके मान दशमलव में न हो तो इस विधि का प्रयोग श्रेयस्कर होता है। इस विधि द्वारा माध्य ज्ञात करने के निम्नलिखित सूत्र हैं:

(i) व्यक्तिगत श्रेणी x̄ = ΣΧ/ N

(ii) खण्डित श्रेणी x̄ = ΣfΧ /N

(iii) अखण्डित श्रेणी x̄ = ΣfΧ /N

जहाँ, x̄ = समान्तर माध्य या औसत,

ΣΧ = पद-मूल्यों का योग

ΣfX = वर्गान्तरों के मध्य मूल्यों तथा आवृत्तियों के गुणनफलों का योग

N = पदों की कुल संख्या

(2) लघु विधि : इस विधि का प्रयोग उस समय करने में सरलता होती है जब समंक-श्रेणी में पद मूल्य अधिक हों तथा उनके मानों में अधिक अंतर न हो। इस विधि में सर्वप्रथम कल्पित माध्य चुन लेते हैं तत्पश्चात् इस कल्पित माध्य से पद-मूल्यों का विचलन ज्ञात कर निम्न सूत्रों का प्रयोग करते हैं-

Measurement of Central Tendencyजहाँ, 

x̄  = माध्य

A = कल्पित माध्य

N = पदों की संख्या

ΣdX = कल्पित माध्य से विचलनों का योग

ΣfdX = आवृत्तियों तथा विचलनों के गुणनफलों का योग

(1) व्यक्तिगत श्रेणी में समान्तर माध्य की गणना :

उदाहरण (1) : किसी कारखाने के 10 श्रमिकों के मासिक वेतनों के आधार पर समान्तर माध्य की गणना कीजिए-

   हल: (a) प्रत्यक्ष विधि:

श्रमिक  मासिक वेतन (रु०)
A 840
B 860
C 855
D 880
E 890
F 905
G 945
H 960
I 925
J 980
N = 10 ΣX = 9040

x̄ = ΣΧ/ N

    = 9040/10

    = 904 रु०

(b) लघु विधि:

    माना कि कल्पित माध्य = 890

श्रमिक

 मासिक वेतन (रु०)

X

 कल्पित माध्य (A  = 890)  से विचलन

अर्थात् X-A 

dX

A 840  840-890=-50
B 860 860-890 = -30
C 855 855-890 = -35
D 880 880-890 = -10
E 890 890-890 = 0
F 905 905-890 = +15
G 945 945-890 = +55
H 960 960-890 = +70
I 925 925-890 = +35
J 980 980-890 = +90
N = 10 ΣdX = +140

x̄  = A+ΣdX/N

     = 890+140/10

      = 9040/10

       = 904

∴ वेतनों का समांतर माध्य = 904 रु०। 

(2) खंडित (Discrete) श्रेणी में समान्तर माध्य की गणना :

उदाहरण (1) : निम्नलिखित आंकड़ों  से माध्य की गणना कीजिए-

   हल: (a) प्रत्यक्ष विधि:

प्राप्तांक

(X)

आवृति

(f)

fx
70 13 910
73 15 1095
75 19 1425
78 23 1794
81 31 2511
85 34 2890
87 18 1566
90 17 1530
92 16 1472
94 14 1316
N = Σf = 200 Σfx = 16509

x̄ = Σfx/ N

    = 16509/200

     = 82.545

 हल: (b) लघु विधि:

  माना कि कल्पित माध्य = A = 81

प्राप्तांक

(X)

आवृति

(f)

X-A = dx fdx
70 13 70-81 = -11 -143 
73 15 73-81 = -8  -120
75 19 75-81 = -6  -114
78 23 78-81 = -3  -69
81 31 81-81 = 0  0
85 34 85-81 = +4  +136
87 18 87-81 = +6  +108
90 17 90-81 = +9  +153
92 16 92-81 = +11  +176
94 14 94-81 = +13  +182
N = Σf = 200 Σfdx = 309 

x̄ = A+ Σfdx/ N

    = 81+309/200

    = 81+1.545

     = 82.545

(3) अविच्छिन्न या अखंडित (Continuous) श्रेणी में समान्तर माध्य की गणना :

उदाहरण (1) : निम्नलिखित आंकड़ों  से समान्तर माध्य की गणना कीजिए-

वर्गान्तर बारंबारता
0-10 10
10-20 12
20-30 15
30-40 17
40-50 20
50-60 16
60-70 12
70-80 8
80-90 7
90-100 3

   हल: (a) प्रत्यक्ष विधि:

वर्गान्तर मध्यमान (Mid Value) बारंबारता या आवृति आवृति X मध्यमान
  (x) (f) (fx)
0-10 5 10 50
10-20 15 12 180
20-30 25 15 375
30-40 35 17 595
40-50 45 20 900
50-60 55 16 880
60-70 65 12 780
70-80 75 8 600
80-90 85 7 595
90-100 95 3 285
Σf या N = 120 Σfx = 5240

x̄ = Σfx/ N 

    = 5240/120

    = 43.666

    = 43.67

 हल: (b) लघु विधि:

  माना कि कल्पित माध्य = A = 45

वर्गान्तर मध्यमान (Mid Value) बारंबारता या आवृति x-A = विचलन fdx
  (x) (f) dx
0-10 5 10 5-45 = -40 -400
10-20 15 12 15-45 = -30 -360
20-30 25 15 25-45 = -20 -300
30-40 35 17 30-45 = -10 -170
40-50 45 20 45-45 = 0 0
50-60 55 16 55-45= +10 +160
60-70 65 12 65-45 = +20 +240
70-80 75 8 75-45 =+30 +240
80-90 85 7 85-45 =+40 +280
90-100 95 3 95-45 =+50 +150
Σf या N = 120 Σfdx = -160

x̄ = A+ Σfdx/ N

    = 45+(-160)/120

     = 5240/120

     = 43.666  

Mean के गुण (Merits):

     माध्य (Mean) सांख्यिकी में केन्द्रीय प्रवृत्ति का सबसे महत्वपूर्ण और व्यापक रूप से उपयोग किया जाने वाला माप है। इसे सामान्यतः अंकगणितीय माध्य (Arithmetic Mean) कहा जाता है। यह किसी भी आँकड़ों के समूह का औसत मान बताता है और पूरे डेटा का प्रतिनिधित्व करता है। माध्य के कई महत्वपूर्ण गुण होते हैं, जिनके कारण इसका उपयोग शिक्षा, अर्थशास्त्र, भूगोल तथा अन्य सामाजिक विज्ञानों में व्यापक रूप से किया जाता है।

(i) सरलता (Simplicity):-

     माध्य की गणना करना बहुत सरल होता है। सभी प्रेक्षणों (observations) का योग करके उन्हें कुल प्रेक्षणों की संख्या से विभाजित कर दिया जाता है। इसलिए इसे समझना और उपयोग करना आसान होता है।

(ii) सभी मानों का उपयोग (Based on All Observations):-

      माध्य की गणना में डेटा के प्रत्येक मान का उपयोग होता है। इसलिए यह पूरे डेटा का सही प्रतिनिधित्व करता है और अधिक विश्वसनीय परिणाम देता है।

(iii) निश्चित एवं स्पष्ट (Definite and Rigidly Defined):-

    माध्य का मान निश्चित होता है और इसे एक ही तरीके से निकाला जाता है। अलग-अलग व्यक्तियों द्वारा गणना करने पर भी परिणाम समान ही आता है।

(iv) बीजगणितीय उपयोगिता (Algebraic Treatment):-

    माध्य का उपयोग विभिन्न गणितीय और सांख्यिकीय विश्लेषणों में आसानी से किया जा सकता है। जैसे– विचलन (Deviation), मानक विचलन (Standard Deviation) और सहसंबंध (Correlation) आदि की गणना में माध्य का प्रयोग किया जाता है।

(v) तुलनात्मक अध्ययन में उपयोगी (Useful for Comparison):-

    माध्य के माध्यम से विभिन्न समूहों या क्षेत्रों के आँकड़ों की तुलना करना आसान हो जाता है। उदाहरण के लिए, किसी कक्षा के छात्रों के औसत अंक निकालकर उनकी उपलब्धि का आकलन किया जा सकता है।

(vi) स्थिरता (Stability):-

    माध्य अपेक्षाकृत स्थिर माप है और छोटे-मोटे परिवर्तन से बहुत अधिक प्रभावित नहीं होता। इसलिए इसे दीर्घकालिक विश्लेषण में भी उपयोगी माना जाता है।    

Mean की सीमाएँ (Demerits):

(i) चरम मानों (Extreme Values) का प्रभाव:-

   माध्य पर बहुत बड़े या बहुत छोटे मानों का अधिक प्रभाव पड़ता है। यदि किसी डेटा में अत्यधिक बड़ा या छोटा मान हो, तो माध्य वास्तविक स्थिति को सही तरीके से प्रदर्शित नहीं करता।

(ii) प्रतिनिधित्व की कमी:-

     कई बार माध्य पूरे डेटा का सही प्रतिनिधित्व नहीं करता। विशेषकर तब, जब आंकड़ों में बहुत अधिक असमानता या फैलाव (dispersion) हो।

(iii) गुणात्मक तथ्यों के लिए अनुपयुक्त:-

    माध्य का उपयोग केवल संख्यात्मक (quantitative) डेटा के लिए किया जा सकता है। गुणात्मक (qualitative) डेटा जैसे रंग, लिंग, धर्म आदि के लिए माध्य का प्रयोग नहीं किया जा सकता।

(iv) अधूरे आंकड़ों में उपयोग कठिन:-

     यदि डेटा अधूरा हो या कुछ मान उपलब्ध न हों, तो माध्य निकालना कठिन हो जाता है।

(v) व्यावहारिक रूप से हमेशा संभव नहीं:-

    कुछ परिस्थितियों में माध्य का मान भौतिक रूप से संभव नहीं होता। जैसे यदि किसी परिवार में औसत बच्चों की संख्या 2.4 निकले, तो वास्तविकता में ऐसा संभव नहीं है।

(vi) सभी मानों का ज्ञान आवश्यक:-

    माध्य निकालने के लिए सभी मानों का ज्ञात होना आवश्यक है। यदि कोई मान छूट जाए, तो परिणाम गलत हो सकता है।

(vii) ग्राफिकल विधि से नहीं निकाला जा सकता:-

     माध्य को सीधे ग्राफ से नहीं निकाला जा सकता, जबकि कुछ अन्य माप जैसे माध्यिका (Median) ग्राफ से भी प्राप्त की जा सकती है।

(viii) खुले वर्ग अंतराल (Open-ended classes) में कठिनाई:-

   जब वर्ग अंतराल खुले हों (जैसे 50 से कम या 100 से अधिक), तब माध्य निकालना कठिन हो जाता है।

भूगोल में व्यावहारिक उपयोग:

     भूगोल का व्यावहारिक उपयोग मानव जीवन के अनेक क्षेत्रों में होता है। यह प्राकृतिक संसाधनों के सही उपयोग, पर्यावरण संरक्षण तथा क्षेत्रीय योजना बनाने में सहायक होता है। भूगोल की सहायता से मौसम पूर्वानुमान, कृषि योजना, जल संसाधन प्रबंधन और आपदा प्रबंधन जैसे कार्य किए जाते हैं। परिवहन, संचार और शहरी विकास की योजनाओं में भी भूगोल का महत्वपूर्ण योगदान है। इसके अलावा उद्योगों की स्थापना, जनसंख्या वितरण तथा भूमि उपयोग के अध्ययन में भी भूगोल उपयोगी सिद्ध होता है। इस प्रकार भूगोल मानव और प्रकृति के बीच संतुलन बनाए रखने तथा सतत विकास को बढ़ावा देने में महत्वपूर्ण भूमिका निभाता है।

निष्कर्ष:

     भूगोल में माध्य (Mean) सांख्यिकीय विश्लेषण का एक महत्वपूर्ण उपकरण है। यह किसी क्षेत्र की जलवायु, जनसंख्या, कृषि उत्पादन आदि के औसत स्तर को समझने में सहायता करता है। हालाँकि, असामान्य मानों की स्थिति में केवल Mean पर निर्भर रहना उचित नहीं है; Median एवं Mode का भी उपयोग आवश्यक है।

2. माध्यिका (Median) 

3. बहुलक (Mode)

Measure of Central Tendency (केन्द्रीय प्रवृत्ति के माप) से संबंधित 30+ महत्वपूर्ण प्रश्नोत्तर, MCQs एवं परीक्षा उपयोगी नोट्स – NET/JRF, Pre-PhD, Assistant Professor, BPSC एवं PG विद्यार्थियों के लिए।


1. केंद्रीय प्रवृत्ति (Central Tendency) का मुख्य उद्देश्य क्या है?

(A) डेटा के मध्य मान को दर्शाना (To represent the central value of data)

(B) डेटा को बढ़ाना (To increase data)

(C) डेटा को हटाना (To remove data)

(D) डेटा को विभाजित करना (To divide data)

[read more] (A) डेटा के मध्य मान को दर्शाना (To represent the central value of data) [/read]

2. निम्नलिखित में कौन केंद्रीय प्रवृत्ति का माप नहीं है?

(A) Mean

(B) Median

(C) Mode

(D) Standard Deviation

[read more] (D) Standard Deviation [/read]

3. यदि डेटा में अत्यधिक चरम मान (Extreme Values) हों, तो कौन-सा माप सबसे उपयुक्त है?

(A) Mean

(B) Median

(C) Mode

(D) Harmonic Mean

[read more] (B) Median [/read]

4. Arithmetic Mean को और किस नाम से जाना जाता है?

(A) Average

(B) Quartile

(C) Variance

(D) Range

[read more] (A) Average [/read]

5. कौन-सा केंद्रीय प्रवृत्ति का माप गुणात्मक (Qualitative) डेटा के लिए सबसे उपयुक्त है?

(A) Mean

(B) Median

(C) Mode

(D) Geometric Mean

[read more] (C) Mode [/read]

6. यदि सभी प्रेक्षण (Observations) समान हों, तो Mean, Median और Mode होंगे-

(A) समान (Equal)

(B) अलग-अलग (Different)

(C) केवल Mean और Median समान

(D) कोई नहीं

[read more] (A) समान (Equal) [/read]

7. खुली वर्ग सीमाओं (Open-ended Class Interval) में कौन-सा माप अधिक उपयुक्त है?

(A) Mean

(B) Median

(C) Mode

(D) Harmonic Mean

[read more] (B) Median [/read]

8. सबसे अधिक बार आने वाला मान कहलाता है-

(A) Mean

(B) Median

(C) Mode

(D) Range

[read more] (C) Mode [/read]

9. Geometric Mean का प्रमुख उपयोग किसमें होता है?

(A) Growth Rate

(B) Age

(C) Height

(D) Weight

[read more] (A) Growth Rate [/read]

10. Harmonic Mean का प्रयोग मुख्यतः किसके लिए किया जाता है?

(A) Average Speed

(B) Rainfall

(C) Population

(D) Temperature

[read more] (A) Average Speed [/read]

11. यदि Mean = Median = Mode हो, तो वितरण (Distribution) होगा-

(A) Positively Skewed

(B) Negatively Skewed

(C) Symmetrical

(D) Bimodal

[read more] (C) Symmetrical [/read]

12. किस माप पर Extreme Values का सबसे अधिक प्रभाव पड़ता है?

(A) Median

(B) Mode

(C) Mean

(D) Quartile

[read more] (C) Mean [/read]

13. यदि सभी मानों में 10 जोड़ दिया जाए, तो Mean होगा-

(A) 10 बढ़ जाएगा

(B) 10 घट जाएगा

(C) अपरिवर्तित रहेगा

(D) शून्य हो जाएगा

[read more] (A) 10 बढ़ जाएगा [/read]

14. यदि सभी मानों को 5 से गुणा किया जाए, तो Mean होगा-

(A) 5 गुना

(B) आधा

(C) समान

(D) शून्य

[read more] (A) 5 गुना [/read]

15. निम्न में कौन-सा संबंध सही है?

(A) Mean ≥ Median ≥ Mode

(B) Mode ≥ Mean ≥ Median

(C) Mean = Range

(D) Median = Variance

[read more] (A) Mean ≥ Median ≥ Mode [/read]

Answer: (A) (Positively Skewed Distribution)

16. किस केंद्रीय प्रवृत्ति माप की गणना सबसे सरल है?

(A) Arithmetic Mean

(B) Harmonic Mean

(C) Geometric Mean

(D) Weighted Mean

[read more] (A) Arithmetic Mean [/read]

17. यदि किसी डेटा में दो Mode हों, तो वह कहलाता है-

(A) Unimodal

(B) Bimodal

(C) Trimodal

(D) Uniform

[read more] (B) Bimodal [/read]

18. सबसे स्थिर (Stable) केंद्रीय प्रवृत्ति का माप कौन-सा है?

(A) Arithmetic Mean

(B) Mode

(C) Median

(D) Range

[read more] (A) Arithmetic Mean [/read]

19. कौन-सा Mean हमेशा Arithmetic Mean से कम या उसके बराबर होता है?

(A) Geometric Mean

(B) Harmonic Mean

(C) दोनों (A) एवं (B)

(D) Median

[read more] (C) दोनों (A) एवं (B) [/read]

20. यदि डेटा अत्यधिक विकृत (Highly Skewed) हो, तो सबसे उपयुक्त माप होगा-

(A) Mean

(B) Median

(C) Mode

(D) Geometric Mean

[read more] (B) Median [/read]

21. यदि Mean = 40 तथा 10 प्रेक्षण हैं, तो कुल योग होगा-

(A) 400

(B) 40

(C) 50

(D) 500

[read more] (A) 400 [/read]

22. किसी डेटा का Mean 25 है। यदि प्रत्येक मान में 5 घटा दिया जाए, तो नया Mean होगा-

(A) 30

(B) 25

(C) 20

(D) 15

[read more] (C) 20 [/read]

23. यदि Mean > Median > Mode, तो वितरण होगा-

(A) Positively Skewed/धनात्मक विकृत

(B) Negatively Skewed

(C) Symmetrical

(D) Uniform

[read more] (A) Positively Skewed [/read]

24. Median निकालने के लिए डेटा का होना आवश्यक है-

(A) Ordered

(B) Random

(C) Grouped only

(D) None

[read more] (A) Ordered [/read]

25. किस स्थिति में Mode अस्तित्व में नहीं भी हो सकता है?

(A) सभी मान अलग-अलग हों

(B) सभी मान समान हों

(C) केवल दो मान हों

(D) सभी धनात्मक हों

[read more] (A) सभी मान अलग-अलग हों [/read]

26. यदि किसी डेटा का Mean = 20 है तथा प्रत्येक मान को दोगुना कर दिया जाए, तो नया Mean होगा-

(A) 20

(B) 30

(C) 40

(D) 10

[read more] (C) 40 [/read]

27. निम्न में कौन-सा कथन सही है?

(A) Mean हमेशा डेटा का वास्तविक मान होता है।

(B) Median पर Extreme Values का प्रभाव कम पड़ता है।

(C) Mode केवल Continuous Data में प्रयुक्त होता है।

(D) Mean कभी दशमलव में नहीं आता।

[read more] (B) Median पर Extreme Values का प्रभाव कम पड़ता है। [/read]

28. यदि किसी वितरण में Mean = Median = Mode = 50, तो वितरण होगा-

(A) Symmetrical

(B) Positively Skewed

(C) Negatively Skewed

(D) Irregular

[read more] (A) Symmetrical [/read]

29. Weighted Mean का उपयोग कब किया जाता है?

(A) जब सभी मानों का समान महत्व हो

(B) जब विभिन्न मानों का भार (Weight) अलग-अलग हो

(C) केवल Nominal Data में

(D) केवल Median निकालने में

[read more] (B) जब विभिन्न मानों का भार (Weight) अलग-अलग हो [/read]

30. निम्न में कौन-सा कथन गलत (Incorrect) है?

(A) Mean सभी प्रेक्षणों पर आधारित होता है।

(B) Median डेटा के मध्य मान को दर्शाता है।

(C) Mode सबसे कम बार आने वाला मान है।

(D) Arithmetic Mean केंद्रीय प्रवृत्ति का सबसे अधिक प्रयुक्त माप है।

[read more] (C) Mode सबसे कम बार आने वाला मान है। [/read]

13. Inductive and Deductive Approaches in Geography / भूगोल में आगमनात्मक एवं निगमनात्मक उपागम

Inductive and Deductive Approaches in Geography

भूगोल में आगमनात्मक एवं निगमनात्मक उपागम

परिचय

      भूगोल पृथ्वी की सतह पर पाए जाने वाले प्राकृतिक तथा मानवीय तत्त्वों और उनके आपसी संबंधों का अध्ययन करने वाला विज्ञान है। इन तत्त्वों को समझने और विश्लेषण करने के लिए भूगोल में विभिन्न उपागम अपनाए जाते हैं। इनमें आगमनात्मक (Inductive) और निगमनात्मक (Deductive) उपागम सबसे महत्वपूर्ण माने जाते हैं।

    आगमनात्मक उपागम में विशिष्ट तथ्यों और अनुभवों के आधार पर सामान्य नियमों का निर्माण किया जाता है, जबकि निगमनात्मक उपागम में पहले से स्थापित सिद्धांतों के आधार पर विशिष्ट घटनाओं की व्याख्या की जाती है। इन दोनों उपागमों ने भूगोल को वर्णनात्मक विषय से वैज्ञानिक और विश्लेषणात्मक विषय के रूप में विकसित करने में महत्वपूर्ण भूमिका निभाई है।

     संक्षेप में भूगोल एक ऐसा विषय है जो पृथ्वी की सतह पर घटित प्राकृतिक तथा मानवीय घटनाओं का अध्ययन करता है। इन घटनाओं को समझने के लिए भूगोल में विभिन्न उपागम (Approaches) अपनाए जाते हैं। उनमें से दो सबसे महत्वपूर्ण उपागम हैं-

1. आगमनात्मक उपागम (Inductive Approach)

2. निगमनात्मक उपागम (Deductive Approach)

     ये दोनों उपागम यह निर्धारित करते हैं कि भूगोल में ज्ञान का निर्माण किस दिशा से और किस प्रकार किया जाए।

उपागम (Approach) का अर्थ:

     उपागम से आशय उस दृष्टिकोण या पद्धति से है, जिसके माध्यम से किसी विषय का अध्ययन किया जाता है। भूगोल में उपागम यह तय करता है कि हम-

✍️ तथ्यों से सिद्धांत तक जाएँ, या

✍️ सिद्धांत से तथ्यों की व्याख्या करें।

आगमनात्मक उपागम (Inductive Approach):

     आगमनात्मक उपागम वह अध्ययन-पद्धति है जिसमें भूगोल का अध्ययन विशिष्ट तथ्यों, घटनाओं और प्रत्यक्ष अवलोकनों से प्रारम्भ होकर सामान्य नियमों या सिद्धांतों के निर्माण तक पहुँचता है। इस उपागम में पहले विभिन्न स्थानों से प्राप्त आँकड़ों और अनुभवों का संग्रह किया जाता है, फिर उनका विश्लेषण एवं तुलना करके सामान्य निष्कर्ष निकाले जाते हैं।

    भूगोल में यह उपागम प्राकृतिक घटनाओं जैसे जलवायु, स्थलरूप, नदियों और मृदा के अध्ययन में विशेष रूप से उपयोगी है। आगमनात्मक उपागम अनुभव और वास्तविकता पर आधारित होने के कारण भूगोल को वैज्ञानिक आधार प्रदान करता है तथा नए नियमों और अवधारणाओं के विकास में सहायक सिद्ध होता है।

      संक्षेप में आगमनात्मक उपागम वह पद्धति है जिसमें- विशिष्ट तथ्यों और उदाहरणों के अध्ययन से सामान्य नियमों या सिद्धांतों तक पहुँचा जाता है। अर्थात पहले तथ्य, फिर नियम

प्रक्रिया:

      आगमनात्मक उपागम की प्रक्रिया में सर्वप्रथम किसी क्षेत्र या घटना से संबंधित प्रत्यक्ष अवलोकन किया जाता है। इसके बाद विभिन्न स्थानों से जुड़े तथ्यों एवं आँकड़ों का संग्रह किया जाता है। संकलित तथ्यों की तुलना और विश्लेषण करके उनमें निहित समानताओं और भिन्नताओं को पहचाना जाता है। अंततः इन विश्लेषित तथ्यों के आधार पर सामान्य नियमों, सिद्धांतों या निष्कर्षों का निर्माण किया जाता है। यह प्रक्रिया अनुभव और वास्तविकता पर आधारित होती है, इसलिए इसे वैज्ञानिक एवं विश्वसनीय माना जाता है।

भूगोल में आगमनात्मक उपागम का प्रयोग:

✍️ प्रारम्भिक भूगोलवेत्ताओं द्वारा व्यापक उपयोग

✍️ अलेक्जेंडर वॉन हम्बोल्ट (Alexander von Humboldt) – क्षेत्रीय अवलोकन, अनुभव और तुलनात्मक अध्ययन के आधार पर सामान्य नियमों की स्थापना।

✍️ वेरेनियस (Bernhard Varenius) – प्राकृतिक तथ्यों से सार्वभौमिक नियम निकालने के पक्षधर।

✍️ विशेष रूप से भौतिक भूगोल और प्रादेशिक भूगोल में उपयोगी।

उदाहरण:

(i) विभिन्न स्थानों के तापमान और वर्षा के आँकड़े एकत्र कर ⇒ जलवायु के सामान्य नियम बनाना

(ii) अनेक नदियों का अध्ययन कर ⇒ नदी के अपरदन और निक्षेपण के नियम निकालना

विशेषताएँ:

(i) विशिष्ट तथ्यों से सामान्य नियमों की ओर अग्रसर

(ii) प्रत्यक्ष अवलोकन और अनुभव पर आधारित

(iii) क्षेत्रीय एवं स्थल-स्तरीय अध्ययन पर बल

(iv) तुलनात्मक विधि का व्यापक प्रयोग

(v) नए सिद्धांतों एवं नियमों की खोज में सहायक

(vi) भौतिक भूगोल के अध्ययन में अधिक उपयोगी

(vii) प्रकृति के वास्तविक स्वरूप के निकट

(viii) वैज्ञानिक सोच और विश्लेषण क्षमता को बढ़ावा देता है।

सीमाएँ (Limitations):

⇒ समय-साध्य प्रक्रिया

⇒ सीमित तथ्यों से गलत सामान्यीकरण का खतरा

⇒ पूर्ण सार्वभौमिक नियम हमेशा संभव नहीं

निगमनात्मक उपागम (Deductive Approach):

          निगमनात्मक उपागम (Deductive Approach) वह अध्ययन-पद्धति है जिसमें पहले से स्थापित सामान्य नियमों, सिद्धांतों या अवधारणाओं के आधार पर विशिष्ट तथ्यों और घटनाओं की व्याख्या की जाती है। इस उपागम में अध्ययन की दिशा सामान्य से विशेष की ओर होती है। सर्वप्रथम किसी सिद्धांत या नियम को स्वीकार किया जाता है, फिर उसके आधार पर परिकल्पनाएँ बनाई जाती हैं और अंत में वास्तविक तथ्यों द्वारा उनकी जाँच की जाती है।

     भूगोल में निगमनात्मक उपागम का प्रयोग प्राकृतिक तथा मानवीय घटनाओं की तार्किक, वैज्ञानिक और व्यवस्थित व्याख्या के लिए किया जाता है। यह उपागम भूगोल को सैद्धांतिक और मात्रात्मक स्वरूप प्रदान करने में महत्वपूर्ण भूमिका निभाता है।

     संक्षेप में निगमनात्मक उपागम वह पद्धति है जिसमें- पहले से स्थापित सामान्य नियमों या सिद्धांतों के आधार पर विशिष्ट घटनाओं की व्याख्या की जाती है। अर्थात पहले नियम, फिर तथ्य।

प्रक्रिया:

      निगमनात्मक उपागम में अध्ययन की शुरुआत पहले से स्थापित सामान्य नियमों या सिद्धांतों से की जाती है। सर्वप्रथम किसी सिद्धांत या मॉडल का चयन किया जाता है, जिसके आधार पर एक परिकल्पना निर्मित की जाती है। इसके बाद संबंधित क्षेत्र से तथ्यों एवं आँकड़ों का संग्रह कर उस परिकल्पना का परीक्षण किया जाता है।

     यदि प्राप्त तथ्य सिद्धांत के अनुरूप होते हैं तो परिकल्पना की पुष्टि होती है, अन्यथा उसमें संशोधन किया जाता है। अंततः निष्कर्ष निकाले जाते हैं, जिनसे किसी विशिष्ट भौगोलिक घटना की व्याख्या की जाती है। इस प्रकार निगमनात्मक उपागम तर्क, विश्लेषण और वैज्ञानिक परीक्षण पर आधारित होता है। अर्थात संक्षेप में

(i) सामान्य सिद्धांत का चयन

(ii) परिकल्पना का निर्माण

(iii) तथ्यों के माध्यम से परीक्षण

(iv) निष्कर्ष की पुष्टि या अस्वीकृति

भूगोल में निगमनात्मक उपागम का प्रयोग:

     इसका आधुनिक भूगोल में व्यापक उपयोग किया जाता है। जैसे- यदि यह सिद्धांत हो कि “औद्योगिक क्षेत्र परिवहन सुविधा के निकट विकसित होते हैं”, तो किसी शहर के औद्योगिक विकास का अध्ययन इसी आधार पर किया जाएगा। इस उपागम से शोध में तार्किकता, स्पष्टता और वैज्ञानिकता बढ़ती है। मानव एवं आर्थिक भूगोल में क्षेत्रीय विश्लेषण, मॉडल परीक्षण तथा स्थानिक पैटर्न समझने में इसका व्यापक प्रयोग होता है। अन्य उदाहरण जलवायु के सिद्धांत के आधार पर किसी क्षेत्र की वर्षा का अनुमान करना, गुरुत्वाकर्षण सिद्धांत से नदी प्रवाह की दिशा को समझना।

विशेषताएँ:

✍️ तर्क और सिद्धांत पर आधारित

✍️ कम समय में निष्कर्ष

✍️ गणितीय एवं सांख्यिकीय विधियों का प्रयोग

लाभ (Merits):

✍️ तेज और व्यवस्थित प्रक्रिया

✍️ वैज्ञानिक और तर्कसंगत

✍️ भविष्यवाणी में सहायक

✍️ मॉडल निर्माण के लिए उपयुक्त

सीमाएँ (Limitations):

✍️ यदि सिद्धांत गलत हो तो निष्कर्ष भी गलत

✍️ स्थानीय विशेषताओं की उपेक्षा

✍️ मानवीय तत्वों को पूर्ण रूप से नहीं समझा पाता

आगमनात्मक और निगमनात्मक उपागम में अंतर

आधार आगमनात्मक निगमनात्मक
दिशा विशेष → सामान्य सामान्य → विशेष
आधार तथ्य, अनुभव सिद्धांत, तर्क
उपयोग प्रादेशिक अध्ययन सामान्य नियम
समय अधिक कम
प्रकृति खोजपरक व्याख्यात्मक

भूगोल में दोनों उपागमों का महत्व: 

       भूगोल में आगमनात्मक उपागम (Inductive Approach) में शोधकर्ता छोटे-छोटे तथ्यों, आंकड़ों और क्षेत्रीय अध्ययन से सामान्य सिद्धांत बनाता है। उदाहरणतः किसी क्षेत्र की वर्षा, तापमान और फसल पैटर्न का अध्ययन कर व्यापक निष्कर्ष निकाले जाते हैं। यह पद्धति अनुभवजन्य और व्यवहारिक ज्ञान को बढ़ाती है।

      वहीं निगमनात्मक उपागम (Deductive Approach) में पहले सिद्धांत स्थापित किए जाते हैं, फिर उन्हें वास्तविक तथ्यों पर परखा जाता है। जैसे जनसंख्या सिद्धांत को किसी शहर के आंकड़ों से जांचना।

        दोनों उपागम परस्पर पूरक हैं और भूगोल को वैज्ञानिक, तर्कसंगत तथा व्यावहारिक आधार प्रदान करते हैं।

निष्कर्ष:

     आगमनात्मक और निगमनात्मक उपागम भूगोल के अध्ययन की दो मूलभूत पद्धतियाँ हैं। आगमनात्मक उपागम तथ्यों से सिद्धांतों तक पहुँचने में सहायक है, जबकि निगमनात्मक उपागम सिद्धांतों के आधार पर घटनाओं की व्याख्या करता है। आधुनिक भूगोल में दोनों उपागमों का समन्वित प्रयोग किया जाता है, जिससे भूगोल अधिक वैज्ञानिक, व्यावहारिक और विश्वसनीय विषय बन गया है।

2. Quartile Deviation (चतुर्थक विचलन)

Quartile Deviation

(चतुर्थक विचलन)


परिचय

     चतुर्थक विचलन (Quartile Deviation) अपसरण का एक महत्वपूर्ण माप है, जो किसी वितरण के मध्य 50% आँकड़ों के फैलाव को दर्शाता है।

     Quartile Deviation is an important measure of dispersion that shows the spread of the middle 50% of observations in a distribution.

✍️ इसे Semi-Interquartile Range भी कहा जाता है।

✍️ It is also known as the semi-interquartile range.

Definition

   Quartile Deviation is half of the difference between the third quartile (Q₃) and the first quartile (Q₁). अर्थात चतुर्थक विचलन, तृतीय चतुर्थक (Q₃) और प्रथम चतुर्थक (Q₁) के अंतर का आधा होता है।

नोट: 

✍️ जिस प्रकार माध्यिका समूह को दो भागों में विभाजित करती है। ठीक उसी प्रकार Quartile Deviation समूह को चार भागों में विभाजित करता है।

✍️ माध्यिका द्वारा बाँटे गये भागों को Quartile दो-दो बराबर भागों में विभाजित करता है।

✍️ प्रथम चतुर्थक माध्यिका से छोटा होता है, यह लघु चतुर्थक कहलाता है।

✍️ दूसरा चतुर्थक माध्यिका होता है।

✍️ तृतीय चतुर्थक माध्यिका से बड़ा होता है, यह दीर्घ चतुर्थक कहलाता है। 

✍️ लघु चतुर्थक को Q1 से तथा दीर्घ चतुर्थक को  Q3 से प्रदर्शित किया जाता है।

✍️ For individual and Discreate series-

Q = (n+1/4)th term

Q3 = 3(n+1/4)th term

Quartile Deviation

where, 

Q1 = First Quartile (Lower Quartile)

Q2 = Second Quartile (Median)

Q3 = Third Quartile (Upper Quartile)

Example: 2, 7, 9, 14, 1 का मध्यिका निकालें।

1, 2, 7, 9, 14

नोट:  Median किसी भी सीरीज को दो बराबर भागों में बांटता है जबकि QD. किसी भी सीरीज को चार बराबर भागों में बांटता है।

✍️ यहाँ ध्यान देना है कि दो भागों में सीरीज को बांटने के लिए मात्र एक Value अर्थात Median की जरुरत होती है, जबकि इसी सीरीज को चार भागों में बाँटने के लिए हमें तीन Value अर्थात Q1, Q2, Q3 की जरुरत होती है।

✍️ Q1 की बात की जाये तो 25% Observation Q1 के पहले जबकि 75% Observation Q1 के बाद आते है।

✍️ Q2 की बात की जाये तो 50% Observation Q2 के पहले जबकि 50% Observation Q2 के बाद अर्थात बराबर बराबर Observation आता है। इस प्रकार Q2 ही Median है।

✍️ Q3 की बात की जाये तो 75% Observation Q3 के पहले जबकि 25% Observation Q3 के बाद आता है।

Quartile Deviation

विशेषताएँ / Merits

✍️ अत्यधिक मानों से कम प्रभावित / Less affected by extreme values

✍️ सरल एवं व्यावहारिक / Simple and easy to understand

✍️ असमान वितरण के लिए उपयुक्त / Suitable for skewed distributions

सीमाएँ / Demerits

✍️ केवल मध्य 50% आँकड़ों पर आधारित /Based only on middle 50% observations

✍️ बीजीय विश्लेषण में अनुपयुक्त / Not suitable for algebraic treatment

महत्व / Importance

✍️ आय एवं वेतन अध्ययन / Income and wage analysis

✍️ सामाजिक-आर्थिक अनुसंधान / Socio-economic research

✍️ जनसंख्या एवं भूगोल अध्ययन / Population & Geography studies

निष्कर्ष:

      इस प्रकार चतुर्थक विचलन एक सरल, विश्वसनीय एवं व्यावहारिक अपसरण माप है, जो असमान वितरण में अत्यंत उपयोगी है। / Quartile Deviation is a simple, reliable, and practical measure of dispersion, especially useful in skewed distributions.

2. Mean Deviation (औसत विचलन)

Mean Deviation

(औसत विचलन)

Mean Deviation

Definition / परिभाषा

      Mean Deviation is a statistical measure of dispersion which is calculated as the average of absolute deviations of observations from a central value (Mean, Median or Mode).

    औसत विचलन वह प्रसार माप है, जिसमें सभी प्रेक्षणों के किसी केंद्रीय मान (माध्य, माध्यिका या बहुलक) से परम विचलनों का औसत निकाला जाता है।

✍️ माध्य विचलन की गणना में सभी विचलनों को धनात्मक माना जाता है। दूसरे शब्दों में, विचलनों के बीजगणितीय चिह्न ‘+’ तथा ‘-‘ (धन तथा ऋण) की उपेक्षा करके सभी विचलनों को धनात्मक माना जाता है अर्थात् ‘निरपेक्ष विचलन’ (absolute deviation) ज्ञात किये जाते हैं।

✍️ चिह्नों को छोड़ने का कारण यह है कि माध्य से निकाले गये विचलनों का योग शून्य तथा अन्य माध्यों से निकाले गये विचलनों का योग, यदि वितरण मामूली असंमितीय हो, लगभग शून्य होता है।

     माध्य विचलन ज्ञात करने में निम्न बातों का ध्यान रखा जाता है:-

(1) माध्य का चुनाव:-

    सैद्धान्तिक रूप से माध्य विचलन किसी भी माध्य (माध्य, माध्यिका अथवा बहुलक) से निकाला जा सकता है परन्तु व्यवहार में माध्य तथा माध्यिका से ही माध्य विचलन की माप ज्ञात को जाती है।

(ii) बीजगणितीय चिह्नों की उपेक्षा:-

      माध्य विचलन ज्ञात करने में विचलनों के बीजगणितीय चिह्नों (धन व ऋण) की उपेक्षा करके सभी विचलनों को धनात्मक माना जाता है। इस प्रकार के विचलनों को व्यक्त करने के लिए ‘d’ (deviation) के दोनों ओर सीधी खड़ी रेखाएँ बना दी जाती है तथा |d| लिखा जाता है। इस संकेताक्षर को ‘mod d’ पुकारा जाता है। इससे आशय ‘निरपेक्ष विचलन’ (absolute deviation) से है, अर्थात् विचलन में ‘+’अथवा ‘-‘ को ध्यान में नहीं रखा गया है।

(iii) विचलनों का माध्य ज्ञात करना:-

    सभी निरपेक्ष विचलनों को छोड़कर पदों की संख्या (N) से भाग देने पर माध्य विचलन ज्ञात हो जाता है।

(iv) संकेताक्षर:-

   माध्य विचलन के संकेताक्षर के रूप में ग्रीक वर्णमाला का अक्षर डेल्टा (Small Delta-‘δ’) का प्रयोग किया जाता है जिसे माध्य से माध्य विचलन ज्ञात किया जाता है उसे δ के साथ उपसंकेत (subscript) के रूप में इस प्रकार लिखा जाता है:

δ= माध्य से माध्य विचलन

(Mean Deviation from Mean)

δM = माध्यिका से माध्य विचलन

(Mean Deviation from Median)

δZ = बहुलक से माध्य विचलन

(Mean Deviation from Mode)

माध्य विचलन गुणांक

(Co-efficient of Mean Deviation)

    Coefficient of Mean Deviation is a relative measure of dispersion obtained by dividing Mean Deviation by the corresponding central value (Mean, Median or Mode). माध्य विचलन गुणांक अपकिरण का सापेक्ष माप है, जिसे माध्य विचलन को संबंधित केंद्रीय मान से भाग देकर प्राप्त किया जाता है।

Coefficient of Mean Deviation (CMD) = MD / A (or MD̄ / A)

Where / जहाँ,

MD = Mean Deviation

A = Central Value (Mean / Median / Mode)

(i) माध्य से माध्य विचलन का गुणांक

(Co-efficient of Mean Deviation from Mean)

Coefficient of Mean Deviation 

= Mean Deviation from Mean / Mean

(ii) माध्यिका से माध्य विचलन गुणांक

(Co-efficient of Mean Deviation from Median)

Coefficient of Mean Deviation 

= Mean Deviation from Median / Median

(iii) बहुलक से माध्य विचलन गुणांक

(Co-efficient of Mean Deviation from Mode)

Coefficient of Mean Deviation 

= Mean Deviation from Mode / Mode

Why Coefficient is Used?

(गुणांक का प्रयोग क्यों?)

✍️ It removes the effect of units

(माप की इकाई का प्रभाव समाप्त करता है)

✍️ Helps in comparison of two or more distributions

(दो या अधिक वितरणों की तुलना में सहायक)

Merits / गुण

✍️ Simple to calculate (गणना में सरल)

✍️ Useful for comparison (तुलना में उपयोगी)

✍️ Easy to understand (समझने में आसान)

Demerits / दोष

✍️ Limited use in advanced statistics

(उन्नत सांख्यिकी में सीमित उपयोग)

✍️ Ignores algebraic signs

(बीजीय चिह्नों की उपेक्षा करता है)

उपयोग (Uses)

✍️ आय, वेतन, वर्षा, तापमान आदि के प्रसार के अध्ययन में

✍️ दो या अधिक वितरणों की तुलना में

माध्य विचलन व उसके गुणांक की गणना

(Computation of Mean Deviation and its Co-efficient)

नोट:

    Coefficient of Mean Deviation from Median is considered most appropriate. माध्यिका से माध्य विचलन गुणांक सबसे उपयुक्त माना जाता है, क्योंकि यह चरम मानों से कम प्रभावित होता है।

(i) व्यक्तिगत श्रेणी (Individual Series)

    माध्य विचलन की गणना प्रत्यक्ष रीति से अथवा लघु रीति से की जा सकती है:-

प्रत्यक्ष रीति (Direct Method)-

    एक व्यक्तिगत श्रेणी में प्रत्यक्ष रीति से माध्य विचलन की गणना करने में निम्नलिखित प्रक्रियाएँ करनी होती है:-

(i) पहले माध्य या माध्यिका या बहुलक, जिससे भी माध्य विचलन निकालना हो, ज्ञात किया जाता है।

(ii) सम्बन्धित माध्य से विभिन्न मूल्यों के निरपेक्ष विचलन |d| ज्ञात किये जाते हैं।

(iii) निरपेक्ष विचलनों का योग ∑|d| ज्ञात किया जाता है।

(iv) ∑|d| में पद संख्या से भाग देकर ‘माध्य विचलन’ ज्ञात किया जाता है। 

इस प्रकार

✍️ δ= ∑|x-x̄|/N or ∑|d|/N

माध्य से माध्य विचलन का गुणांक (CMD) = δ/x̄

Co-efficient of Mean Deviation

✍️ δM = ∑|x-M|/N or ∑|dM|/N

माध्यिका से माध्य विचलन (CMD) = δM/M

Co-efficient of Mean Deviation

✍️ δZ = ∑|x-z|/N or ∑|dz|/N

बहुलक से माध्य विचलन (CMD) =  δZ/Z

Co-efficient of Mean Deviation

NOTE: Mean deviation

✍️ With the help of Mean

✍️ With the help of Median यही दो प्रचलित है। 

✍️ माध्यिका से औसत विचलन सबसे उपयुक्त माना जाता है क्योंकि चरम मानों का प्रभाव न्यूनतम होता है।

Example (i) निम्नलिखित आंकड़ों के माध्य और माध्यिका की सहायता से माध्य विचलन की गणना करें:

Calculate mean deviation with the help of mean and median of the following data:

S.No. X
1 5
2 8
3 11
4 12
5 14

हल:

✍️ With the help of Mean

S.No. X x – x̄
1 5 5
2 8 2
3 11 1
4 12 2
5 14 4
  N = 50 14

M.D. (δx̄) = ∑|x-x̄|/N or ∑|d|/N

NOTE: Modulus का मतलब केवल positive होता है

x̄ = Σx/N

    = 50/5

    = 10

Now, δx̄ = ∑|x-x̄|/N

                = 14/5

                = 2.8 

माध्य से माध्य विचलन का गुणांक (CMD)

= δ/x̄

 = 2.8/10

                                                                 = 0.28

✍️ With the help of Median

नोट: यहाँ सबसे पहले X के मान को बढ़ते क्रम में Arrange करना है हलांकि यहाँ पहले से प्रश्न में ही Arrange है

S.No. X X-M
1 5 6
2 8 3
3 11 0
4 12 1
5 14 3
  Total sum = 13

δM = ∑|x-M|/N or ∑|dM|/N

 Median = (n+1/2)th Observation

                 = (5+1/2)th Observation

                  =( 6/2)th Observation

                  = 3th Observation

                  = 11

Now, MD (δM) = ∑|x-M|/N or ∑|dM|/N

                             = 13/5

                             = 2.6

माध्यिका से माध्य विचलन (CMD) = δM/M

                                                               = 2.6/11

                                                                = 0.23

नोट: यहाँ ध्यान देना है कि Mean और Median अलग-अलग होता है, इसीलिए MD भी अलग-अलग होगा

(ii) खण्डित श्रेणी (Discrete Series)

प्रत्यक्ष रीति (Direct Method)- खण्डित श्रेणी में प्रत्यक्ष रीति से माध्य विचलन ज्ञात करने में निम्नलिखित प्रक्रिया करनी पड़ती है:

(i) जिस माध्य से विचलन ज्ञात करना है, उसे ज्ञात किया जाता है।

(ii) उस माध्य से प्रत्येक आकार () के निरपेक्ष विचलन |d| ज्ञात किये जाते है।

(iii) निरपेक्ष विचलनों |d| को सम्बन्धित आवृत्तियों से गुणा करके, गुणनफलों का योग: Σf|d|, Σf|dM|, Σf|dz|, ज्ञात किया जाता है।

(iv) निम्नलिखित सूत्र के प्रयोग से माध्य विचलन ज्ञात किया जाता है: δx̄, = Σf|d|/N ,δM = Σf|dM|/N δZ= Σf|dz|/N

(v) माध्य विचलन गुणांक ज्ञात करने के लिए माध्य विचलन में सम्बन्धित माध्य का भाग दिया जाता है।

Example (ii) निम्नलिखित आंकड़ों के माध्य और माध्यिका की सहायता से माध्य विचलन की गणना करें:

Calculate mean deviation with the help of mean and median of the following data:

आकार (Size) आवृति (Frequency)
10 3
11 12
12 18
13 12

हल:

✍️ With the help of mean

x f fx x – x̄। fx – x̄
10 3 30 1.87 5.16
11 12 132 0.87 10.44
12 18 216 0.13 2.39
13 12 156 1.13 13.56
Total 45 534 31.95

x̄ = Σfx/Σf

= 534/45

= 11.87

MD (δx̄), = Σf|x – x̄|/Σf or Σf|d|/Σf

= 31.95/45

= 0.71

Co-efficient of MD = MD/x̄

= 0.71/11.87

= 0.095

✍️ With the help of Median

x f Cf |X-M| f|X-M|
10 3 3 (0-3) 2 6
11 12 15 (3-15) 1 12
12 18 33 (15-33) 0 0
13 12 45 (33-45) 1 12
Total 45 30

 here, M = (N+1/2)th term

                = (45+1/2)th term

                = (46/2)th term

                = 23th term

                = 12

now,

MD (δM) = Σf|X-M|/Σf or Σf|dM|/Σf

                  = 30/45

                  = 0.66

Co-efficient of MD = MD/δM

                                  = 0.66/12

                                  = 0.055

(iii) सतत् श्रेणी (Continuous Series)

अविच्छिन्न अथवा सतत् श्रेणी में माध्य विचलन की गणना

(Calculation of Mean Deviation in Continuous Series)-

       अविच्छिन्न अथवा सतत् श्रेणी में माध्य विचलन ज्ञात करने की वही रीति है जो खण्डित श्रेणी में अपनायी जाती है। केवल इतना अन्तर है कि सतत् श्रेणी में मध्य-बिन्दु (mid-point) ‘m’ निकालकर उन्हें मूल्य मान लिया जाता है। इस प्रकार सतत् श्रेणी एक खण्डित श्रेणी का स्वरूप ले लेती है। अन्य प्रक्रियाएँ वैसी ही रहती है।

Example (iii) निम्नलिखित आंकड़ों के माध्य और माध्यिका की सहायता से माध्य विचलन की गणना करें:

Calculate mean deviation with the help of mean and median of the following data:

Class आवृति (Frequency)
2-4 3
4-6 4
6-8 2
8-10 1

हल:

✍️ With the help of mean

x f mv fmv x – x̄। f।x – x̄।
2-4 3 3 9 2.2 6.6
4-6 4 5 20 0.2 0.8
6-8 2 7 14 1.8 3.6
8-10 1 9 9 3.8 3.8
Total 10 52 14.8

Note: x = mv 

MD (δx̄), = Σf|x – x̄|/Σf or Σf|d|/Σf

here,  x̄ = Σfmv/Σf

               = 52/10

                = 5.2

now, MD (δx̄), = Σf|x – x̄|/Σf 

                               = 14.8/10

                                = 1.48

Co-efficient of MD = MD/x̄

                                               = 1.48/5.2

                                               = 0.28

✍️ With the help of Median

x f cf mv ।X– M। f।X- M।
2-4 3 3 3 2 6
4-6 4 7 5 0 0
6-8 2 9 7 2 4
8-10 1 10 9 4 4
Total 10   14

MD (δM) = Σf|X-M|/Σf

here, M (Median) = (N+1/2)th term

= (10+1/2)th term

= 5.5th term

= (4-6) =4

L = 4

N = Σf = 10

cf = 3

f = 4

h = 2

now, M = 4+10/2-3/4 x 2

= 4 +2/2

= 5

MD (δM) = Σf|X-M|/Σf

= 14/10

= 1.4

Co-efficient of MD = MD/M

= 1.5/5

   = 0.28

16. Questionnaire, Schedule and Interview Method (प्रश्नावली, अनुसूची एवं साक्षात्कार विधि)

Questionnaire, Schedule and Interview Method

(प्रश्नावली, अनुसूची एवं साक्षात्कार विधि)


Questionnaire

परिचय

    सामाजिक विज्ञान, शिक्षा, भूगोल, अर्थशास्त्र एवं अन्य शोध क्षेत्रों में प्राथमिक आँकड़ों (Primary Data) का विशेष महत्व होता है। प्राथमिक आँकड़े सीधे क्षेत्र से एकत्र किए जाते हैं, जिससे अध्ययन अधिक यथार्थपरक और विश्वसनीय बनता है।

    प्राथमिक आँकड़ों के संकलन के लिए अनेक विधियाँ प्रचलित हैं, जिनमें प्रश्नावली (Questionnaire), अनुसूची (Schedule) तथा साक्षात्कार विधि (Interview Method) सबसे अधिक प्रयोग की जाती हैं। ये तीनों विधियाँ शोधकर्ता को प्रत्यक्ष रूप से उत्तरदाताओं से जानकारी प्राप्त करने में सहायता करती हैं।

1. प्रश्नावली (Questionnaire)

प्रश्नावली का अर्थ

      प्रश्नावली प्रश्नों का एक सुव्यवस्थित लिखित रूप होती है, जिसे उत्तरदाताओं को दिया जाता है ताकि वे स्वयं अपने उत्तर लिख सकें। इसमें शोध से संबंधित प्रश्न पहले से निर्धारित होते हैं।

परिभाषा

     प्रश्नावली वह साधन है, जिसके माध्यम से शोधकर्ता लिखित प्रश्नों द्वारा उत्तरदाताओं से जानकारी प्राप्त करता है।

प्रश्नावली की विशेषताएँ

✍️ यह लिखित रूप में होती है।

✍️ उत्तरदाता स्वयं प्रश्न पढ़कर उत्तर देता है।

✍️ प्रश्न क्रमबद्ध और स्पष्ट होते हैं।

✍️ यह कम लागत वाली विधि है।

✍️ बड़े क्षेत्र और अधिक जनसंख्या के अध्ययन में उपयोगी है।

प्रश्नावली के प्रकार

(i) संरचित प्रश्नावली

(Structured Questionnaire)

✍️ प्रश्न निश्चित और पूर्वनिर्धारित होते हैं।

✍️ उत्तर के विकल्प पहले से दिए जाते हैं।

(ii) असंरचित प्रश्नावली

(Unstructured Questionnaire)

✍️ प्रश्न खुले होते हैं।

✍️ उत्तरदाता स्वतंत्र रूप से उत्तर देता है।

(iii) खुले प्रश्न

(Open-ended Questions)

✍️ उत्तरदाता अपनी भाषा में उत्तर देता है।

(iv) बंद प्रश्न

(Close-ended Questions)

✍️ ‘हाँ/नहीं’, बहुविकल्पीय (MCQ) आदि।

प्रश्नावली निर्माण के सिद्धांत

✍️ प्रश्न सरल और स्पष्ट हों।

✍️ प्रश्न संक्षिप्त हों।

✍️ एक प्रश्न में एक ही बात पूछी जाए।

✍️ कठिन और संवेदनशील प्रश्न अंत में रखें।

✍️ तकनीकी शब्दों से बचें।

✍️ प्रश्न तार्किक क्रम में हों।

प्रश्नावली के लाभ

✍️ कम समय और कम खर्च में जानकारी प्राप्त होती है।

✍️ पक्षपात की संभावना कम होती है।

✍️ उत्तरदाता स्वतंत्र होकर उत्तर देता है।

✍️ आँकड़ों का विश्लेषण सरल होता है।

प्रश्नावली की सीमाएँ

✍️ अशिक्षित उत्तरदाताओं के लिए अनुपयुक्त।

✍️ प्रश्न गलत समझे जाने की संभावना।

✍️ उत्तर न मिलने (Non-response) की समस्या।

✍️ भावनात्मक एवं गहन जानकारी प्राप्त करना कठिन।

2. अनुसूची (Schedule)

अनुसूची का अर्थ

     अनुसूची प्रश्नों की एक सूची होती है, जिसे शोधकर्ता या गणनाकर्ता स्वयं उत्तरदाता से पूछकर भरता है। इसमें उत्तरदाता को स्वयं लिखने की आवश्यकता नहीं होती।

परिभाषा

    अनुसूची वह विधि है, जिसमें शोधकर्ता प्रत्यक्ष रूप से उत्तरदाता से प्रश्न पूछकर उत्तर लिखता है।

अनुसूची की विशेषताएँ

✍️ यह भी प्रश्नों का लिखित रूप होती है।

✍️ इसे गणनाकर्ता द्वारा भरा जाता है।

✍️ अशिक्षित लोगों के लिए उपयुक्त।

✍️ उत्तर की शुद्धता अधिक होती है।

अनुसूची के प्रकार

(i) संरचित अनुसूची – निश्चित प्रश्न और विकल्प।

(ii) असंरचित अनुसूची – खुले प्रश्नों पर आधारित।

अनुसूची के लाभ

✍️ अशिक्षित उत्तरदाताओं से भी जानकारी मिलती है।

✍️ उत्तर अधिक पूर्ण और सही होते हैं।

✍️ उत्तर न मिलने की समस्या कम होती है।

✍️ प्रश्न समझाने की सुविधा होती है।

अनुसूची की सीमाएँ

✍️ समय और धन अधिक लगता है।

✍️ प्रशिक्षित गणनाकर्ताओं की आवश्यकता।

✍️ व्यक्तिगत पक्षपात की संभावना।

✍️ बड़े क्षेत्र में प्रयोग कठिन।

प्रश्नावली और अनुसूची में अंतर

आधार प्रश्नावली अनुसूची
भरने वाला उत्तरदाता स्वयं गणनाकर्ता
साक्षरता आवश्यक आवश्यक नहीं
लागत कम अधिक
समय कम अधिक
शुद्धता अपेक्षाकृत कम अधिक

3. साक्षात्कार विधि (Interview Method)

साक्षात्कार का अर्थ

     साक्षात्कार वह विधि है, जिसमें शोधकर्ता और उत्तरदाता के बीच प्रत्यक्ष मौखिक संवाद के माध्यम से जानकारी प्राप्त की जाती है।

परिभाषा

    साक्षात्कार वह प्रक्रिया है, जिसमें शोधकर्ता प्रश्न पूछकर मौखिक रूप से उत्तर प्राप्त करता है।

साक्षात्कार के प्रकार

(i) संरचित साक्षात्कार

✍️ प्रश्न पहले से तय होते हैं।

✍️ सभी उत्तरदाताओं से समान प्रश्न।

(ii) असंरचित साक्षात्कार

✍️ प्रश्न लचीले होते हैं।

✍️ गहन अध्ययन के लिए उपयोगी।

(iii) अर्ध-संरचित साक्षात्कार

✍️ कुछ प्रश्न निश्चित, कुछ खुले।

(iv) व्यक्तिगत साक्षात्कार

✍️ एक-से-एक संवाद।

(v) समूह साक्षात्कार

✍️ एक साथ कई उत्तरदाता।

(vi) टेलीफोन/ऑनलाइन साक्षात्कार

✍️ आधुनिक तकनीक पर आधारित।

साक्षात्कार के लाभ

✍️ गहन और भावनात्मक जानकारी प्राप्त होती है।

✍️ प्रश्न स्पष्ट किए जा सकते हैं।

✍️ उत्तर की प्रामाणिकता अधिक।

✍️ अशिक्षित व्यक्तियों से भी जानकारी संभव।

साक्षात्कार की सीमाएँ

✍️ समय और खर्च अधिक।

✍️ साक्षात्कारकर्ता का पक्षपात।

✍️ सीमित उत्तरदाताओं तक ही संभव।

✍️ रिकॉर्डिंग और विश्लेषण कठिन।

तीनों विधियों का तुलनात्मक अध्ययन

आधार प्रश्नावली अनुसूची साक्षात्कार
प्रकृति लिखित लिखित मौखिक
उत्तरदाता स्वयं गणनाकर्ता के माध्यम से प्रत्यक्ष
लागत कम मध्यम अधिक
समय कम अधिक सबसे अधिक
गहनता कम मध्यम अधिक
उपयोग बड़े सर्वेक्षण ग्रामीण/अशिक्षित क्षेत्र केस स्टडी

उपयुक्तता (Suitability)

✍️ प्रश्नावली – बड़े क्षेत्र, साक्षर उत्तरदाता, सीमित बजट।

✍️ अनुसूची – ग्रामीण क्षेत्र, अशिक्षित जनसंख्या।

✍️ साक्षात्कार – गहन अध्ययन, सामाजिक समस्याएँ, केस स्टडी।

निष्कर्ष:

    प्रश्नावली, अनुसूची और साक्षात्कार विधि ये तीनों ही प्राथमिक आँकड़ा संग्रह की महत्वपूर्ण विधियाँ हैं। शोध का उद्देश्य, क्षेत्र, समय, धन और उत्तरदाताओं की प्रकृति के अनुसार उपयुक्त विधि का चयन किया जाना चाहिए। एक सफल शोध के लिए आवश्यक है कि शोधकर्ता इन विधियों का संतुलित, वैज्ञानिक और नैतिक प्रयोग करे।

15. Range (परास / परिसर / विस्तार)

Range

(परास)


Range

परिचय

       परास (Range) प्रसरण का सबसे सरल और प्रारम्भिक मापक है। यह किसी आँकड़ा-समूह में सबसे बड़े मान (L) और सबसे छोटे मान (S) के बीच का अंतर दर्शाता है। इससे यह पता चलता है कि आँकड़े कितनी सीमा तक फैले हुए हैं।

     दूसरे शब्दों में किसी श्रृंखला के सबसे बड़े मूल्य और सबसे छोटे मूल्य के अंतर को परिसर या विस्तार कहते है।

परिभाषा (Definition)

    परास वह अंतर है जो किसी श्रेणी के अधिकतम मान और न्यूनतम मान के बीच होता है।

सूत्र (Formula)

Range (R) = L−S

जहाँ,

= सबसे बड़ा मान (Largest Value / Observation)

= सबसे छोटा मान (Smallest Value / Observation)

परास का गुणांक (Coefficient of Range)

     परास के तुलनात्मक अध्ययन के लिए परास का गुणांक प्रयोग किया जाता है।

Coefficient of Range = (L − S) / (L + S)

✍️ विशेषता:- इसका मान 0 और 1 के बीच होता है।

उदाहरण (Example)

मान लीजिए आँकड़े हैं: 5, 8, 12, 20, 25

L = 25

S = 5

Range

R = 25−5 = 20

Coefficient of Range

(25−5) / (25+5) = 20/30 =0.67

परास के लाभ (Merits)

✍️ Dispersion के सभी methods में यह सबसे सरल व आसान है।

✍️ प्रारम्भिक विश्लेषण के लिए उपयोगी।

✍️ आँकड़ों के फैलाव का त्वरित अनुमान देता है।

परास की सीमाएँ (Demerits)

✍️ Range is not based on each and every observation of the series.

✍️ केवल दो चरम मानों (L और S) पर आधारित।

✍️ चरम मानों के परिवर्तन से बहुत प्रभावित।

✍️ संपूर्ण आँकड़ा-समूह का सही प्रतिनिधित्व नहीं करता।

✍️ We can not calculate Range for open end classification.

उपयोग (Uses)

✍️ मौसम विज्ञान (तापमान का अंतर)

✍️ शेयर बाजार (उच्चतम–न्यूनतम भाव)

✍️ खेल, परीक्षा अंकों का प्रारम्भिक विश्लेषण

✍️ उद्योगों में quality नियंत्रण में उपयोगी

✍️Everyday life (सब्जी या कोई सामान का range)

निष्कर्ष (Conclusion)

    परास प्रसरण का सबसे सरल मापक है, परन्तु इसकी सीमाओं के कारण गहन सांख्यिकीय विश्लेषण में अन्य मापकों (चतुर्थक विचलन, माध्य विचलन, मानक विचलन) का प्रयोग अधिक उपयुक्त माना जाता है।


NOTE: Type of series

(i) Indivisual Series

(ii) Discrete Series

(iii) Continuous Series 

                   ⇓

(a) Exclusive Series

(b) Inclusive Series

उदाहरण (Example)

(i) Indivisual Series

1. 13, 20, 7, 15, 29, 35 इस सीरीज का Range और Coefficient of Range निकालें।

हल:

L = 35

S = 7

Range = L – S = 35 – 7 = 28

Coefficient of Range = (L-S)/(L+S)

= (35 – 7)/(35 + 7) = 28/42 = 0.67

2.  50, 69, 92, 85, 55, 20, 30 इस सीरीज का Range और Coefficient of Range निकालें।

हल:

L = 92

S = 20

Range = L – S =92-20 = 72

Coefficient of Range = (L-S)/(L+S)

= (92-20)/(92+20) = 72/112 = 0.64

(ii) Discrete Series (खंडित श्रेणी)

3. दिए गये सीरीज का Range और Coefficient of Range निकालें।

x f
5 3
10 7
15 5
20 12
25 9

हल:

Note : ऐसे series में Frequency को ignore करना है

L = 25

S = 5

Range = L – S = 25 – 5 = 20

Coefficient of Range = (L-S)/(L+S)

= (25-20)/(25+5) = 20/30 = 0.67

4. दिए गये सीरीज का Range और Coefficient of Range निकालें।

x f
133 9
180 2
80 4
95 5
40 3
132 10

हल:

L = 180

S = 40

Range = L – S = 180 – 40 = 140

Coefficient of Range = (L-S)/(L+S)

= (180-40)/(180+40) = 140/220 = 0.63

(iii) Continuous Series : (a) Exclusive Series

5. दिए गये सीरीज का Range और Coefficient of Range निकालें।

x f
20-25 2
25-30 5
30-35 9
35-40 4
40-45 7

हल:

Note : ऐसे Series में भी Frequency को ignore करना है

L = 45

S = 20

Range = L – S = 45 – 20 = 25

Coefficient of Range = (L-S)/(L+S)

= (45-20)/(45+20) = 25/65 = 0.38

(b) Inclusive Series

5. दिए गये सीरीज का Range और Coefficient of Range निकालें।

x f
20-24 2
25-29 5
30-34 9
35-39 4
40-44 7

हल:

       सबसे पहले यहाँ Inclusive Series को Exclusive Series में बदलते है और यहाँ भी Frequency को ignore करना है

इसके लिए (24+25)/2 = 49/2 = 24.5 इसी तरह सभी निकालें

x f
19.5-24.5 2
24.5-29.5 5
29.5-34.5 9
34.5-39.5 4
39.5-44.5 7

अब, L = 44.5

S = 19.5

Range = L – S = 44.5-19.5 = 25

Coefficient of Range = (L-S)/(L+S)

= (44.5-19.5)/(44.5+19.5) =25/63 = 0.40

error: